

Se lavori con Claude Code tutti i giorni, prima o poi ti ritrovi a incollare in chat le stesse istruzioni: la checklist dell’audit, il formato del report per il cliente, i passaggi per pubblicare un articolo. Oppure il CLAUDE.md cresce fino a diventare un manuale che Claude si porta in contesto a ogni messaggio, anche quando il compito non c’entra. Le skill servono a questo: impacchetti una procedura una volta, Claude la carica solo quando serve e tu puoi richiamarla con un comando.
Questa guida spiega cosa sono, quando usarle al posto di CLAUDE.md, server MCP o subagent, e poi ne costruisce una dall’inizio alla fine: seo-title-audit, che legge l’export CSV di un crawl e segnala title, meta description e H1 mancanti, duplicati o fuori misura. Il codice è completo e copiabile.
Come è stata verificata. Le affermazioni tecniche vengono dalla documentazione ufficiale di Anthropic e dalla specifica dello standard Agent Skills, lette per intero il 2 ottobre 2026. La skill è stata eseguita su Claude Code 2.1.282 con Claude Opus 5.5, su un CSV di prova costruito per contenere ogni caso limite. I test di attivazione sono riportati con i risultati reali, compreso quello che ha fatto emergere una lacuna.
Cos’è una skill di Claude
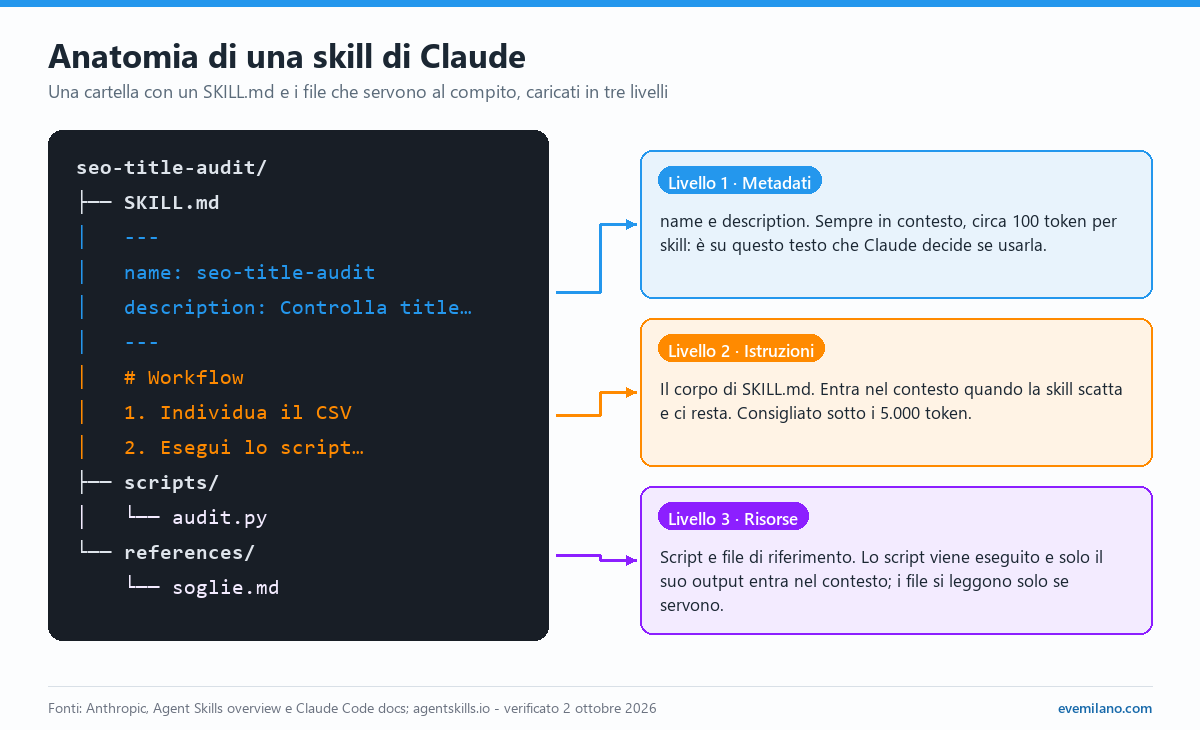
Una cartella con un file SKILL.md
Una skill è una cartella. Dentro c’è almeno un file SKILL.md, fatto di due parti:
- un’intestazione YAML (il frontmatter) racchiusa tra due righe
---, con il nome e la descrizione; - le istruzioni in markdown che Claude segue quando la skill entra in gioco.
Accanto a SKILL.md metti quello che serve al compito: script, documentazione di riferimento, template, dati. Anthropic la paragona alla guida di onboarding che prepari per un nuovo collega: la consulti quando serve, non la impari a memoria.
Il problema che risolve
Quattro problemi concreti:
- prompt ripetuti: la stessa procedura incollata in chat a ogni sessione;
- contesto sprecato: tutto quello che sta nel CLAUDE.md viene caricato sempre, anche quando non serve;
- esecuzione variabile: senza istruzioni scritte, Claude risolve lo stesso problema in modo diverso ogni volta;
- conoscenza non condivisa: la procedura vive nella testa di chi la conosce, non nel repository.
La documentazione di Claude Code lo riassume così: crea una skill quando continui a incollare in chat le stesse istruzioni, o quando una sezione del CLAUDE.md è diventata una procedura invece che un fatto.
Progressive disclosure: i tre livelli di caricamento
Le skill costano poco perché vengono caricate in tre fasi (progressive disclosure):
| Livello | Quando si carica | Costo in contesto |
|---|---|---|
| Nome e descrizione | Sempre, all’avvio | Circa 100 token per skill |
| Corpo di SKILL.md | Quando la skill scatta | Consigliato sotto i 5.000 token |
| File e script allegati | Solo se servono | Zero finché non vengono letti |
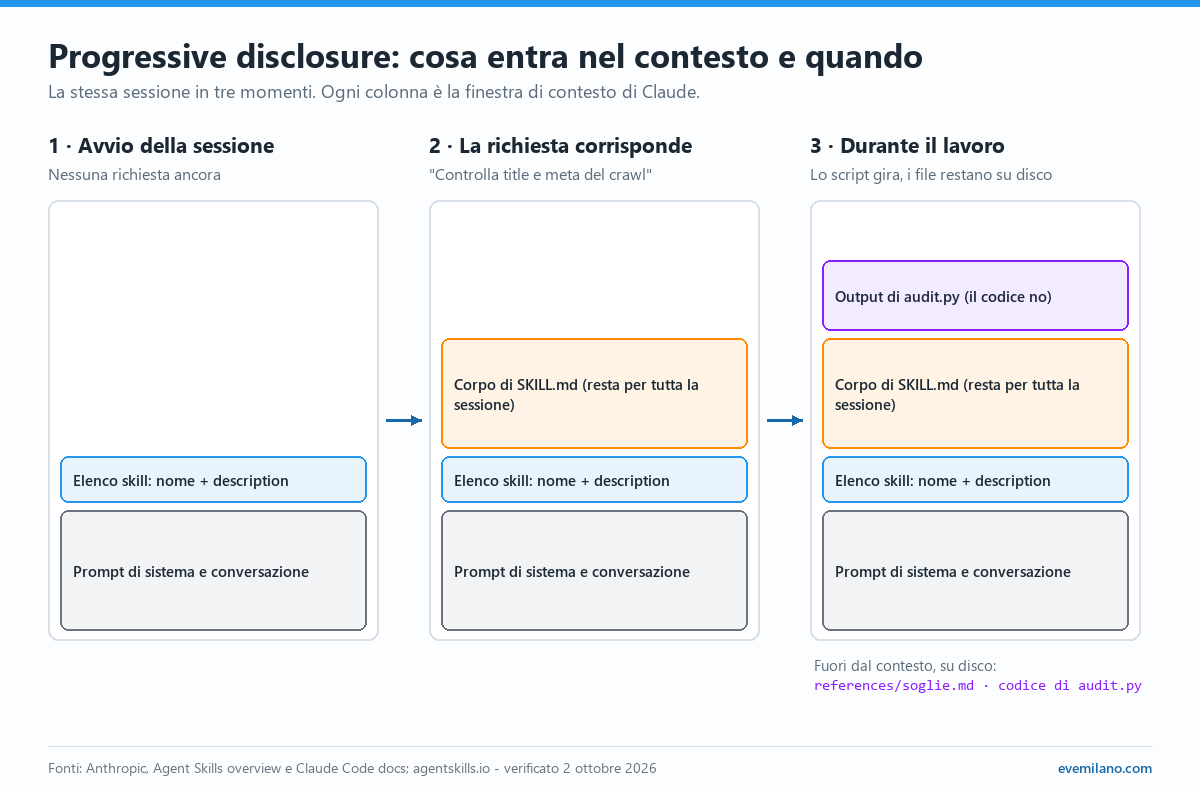
Due conseguenze pratiche:
- puoi avere decine di skill installate senza appesantire ogni conversazione: finché non scattano, occupano solo nome e descrizione;
- uno script allegato non entra mai nel contesto: Claude lo esegue e legge solo l’output. Per i compiti deterministici (conteggi, validazioni, parsing) uno script è più affidabile ed economico di Claude che riscrive ogni volta lo stesso codice.
Il rovescio della medaglia. Una volta caricato, il corpo della skill resta nella conversazione per tutti i turni successivi, e Claude Code non rilegge il file. Ogni riga è quindi un costo che si ripete: per questo la documentazione chiede istruzioni stringate.
Skill, CLAUDE.md, subagent e server MCP: cosa usare e quando
Sono strumenti che si somigliano ma rispondono a domande diverse.
- CLAUDE.md: fatti e regole che valgono sempre nel progetto (convenzioni, comandi, vincoli). Si carica intero a ogni sessione. Come funziona e dove sta lo spiego nella guida a dove Claude Code salva memoria e configurazione.
- Skill: procedure e conoscenza che servono solo in certi compiti. Si carica quando serve, in automatico o con
/nome-skill. - Subagent: un’altra istanza di Claude con un contesto separato, per compiti isolati o paralleli. Il meccanismo è descritto nella guida alla programmazione agentica. Una skill può anche girare dentro un subagent, con
context: fork. - Server MCP: collega Claude a sistemi esterni e dati vivi, come API, database o Search Console. La skill insegna come fare un lavoro, il server MCP fornisce gli strumenti per farlo. Per configurarne uno c’è la guida pratica ai server MCP con Claude Code.
| Strumento | Cosa porta | Esempio SEO |
|---|---|---|
| CLAUDE.md | Regole sempre attive | Lingua dei report |
| Skill | Procedura su richiesta | Audit dei title da un crawl |
| Subagent | Contesto separato | 50 pagine analizzate in parallelo |
| Server MCP | Dati e strumenti esterni | Query a Search Console |
E gli slash command personalizzati? Non sono più un oggetto a sé: la documentazione di Claude Code dice che i comandi personalizzati sono confluiti nelle skill. Un file .claude/commands/deploy.md e una skill .claude/skills/deploy/SKILL.md creano entrambi il comando /deploy e funzionano allo stesso modo. I vecchi file continuano a funzionare, ma per il lavoro nuovo conviene la skill, che può avere file allegati e attivarsi da sola.
Quando una skill non serve
- La regola vale sempre (“rispondi in italiano”, “non fare commit”): va nel CLAUDE.md. In una skill verrebbe ignorata finché la skill non scatta.
- Ti serve un dato che cambia (traffico, posizioni, stato di un ordine): serve un server MCP o una API. La skill può spiegare come usarlo, ma non lo produce.
- La regola deve valere ogni volta, senza eccezioni (bloccare una scrittura, validare prima di un commit): serve un hook. La documentazione è esplicita: se Claude salta una regola che deve valere sempre, spostala in un hook, che viene eseguito a ogni evento indipendentemente dal fatto che Claude stia seguendo la skill.
- Lo fai una volta sola: basta un prompt.
A cosa servono: casi d’uso concreti
Una skill rende quando il compito ha passi fissi e un formato di output atteso. Alcuni esempi dal lavoro SEO e sui contenuti:
- Audit tecnici ripetibili: title e meta da un crawl (l’esempio di questa guida), catene di redirect, dati strutturati verificati con le tue regole e non con quelle generiche.
- Analisi dei log: verifica dell’identità dei bot, filtri sul rumore, sempre gli stessi grafici. È il tipo di procedura descritta nella guida all’analisi dei log per la SEO.
- Briefing editoriali: tono, struttura e regole E-E-A-T del blog trasformati in istruzioni che Claude legge solo quando scrive.
- Report per i clienti: stessa struttura, stessi KPI, stesso ordine delle sezioni ogni mese.
- Documenti Office e PDF: Anthropic fornisce skill pronte per PowerPoint, Excel, Word e PDF su claude.ai e via API. La panoramica della piattaforma le indica come non disponibili in Claude Code, ma la documentazione di Claude Code precisa che, se accedi con un account claude.ai, alcune skill di Anthropic come
pdfexlsxvengono sincronizzate anche nel terminale. - Procedure di team: una skill di progetto versionata in
.claude/skills/arriva a chiunque cloni il repository.
Come le uso io
Il progetto con cui gestisco questo blog è un agente Claude Code che legge e scrive su WordPress tramite REST API. Ha una cartella skills/ con un indice, ___skills_index.md, che elenca procedure e strumenti, ognuno con due righe: “Attivala quando” e “NON attivarla”. Il CLAUDE.md non elenca le procedure ma rimanda all’indice, e Claude apre solo il file che gli serve. Gli script Python stanno accanto alle istruzioni.
È progressive disclosure fatta a mano. Studiando il formato ufficiale ho capito il suo limite: quei file si chiamano SKILL.md ma non sono skill native. Non hanno frontmatter e non stanno in .claude/skills/, quindi Claude Code non li registra: non compaiono nel menu /, non hanno una descrizione sempre presente in contesto e, se Claude non apre l’indice, non sa che esistono. Il sistema regge perché il CLAUDE.md ricorda l’indice a ogni sessione. Per migrarle al formato nativo basta spostare la cartella e aggiungere due righe di frontmatter, che sono il tema della prossima sezione.
Anatomia di una skill
La struttura della cartella
seo-title-audit/
├── SKILL.md            frontmatter + istruzioni (obbligatorio)
├── scripts/
│   └── audit.py        eseguito, il codice non entra nel contesto
└── references/
    └── soglie.md       letto solo se serve
Le cartelle scripts/, references/ e assets/ sono convenzioni dello standard aperto Agent Skills, non obblighi. Puoi organizzare i file come preferisci, purché SKILL.md dica cosa contengono e quando aprirli.
Il frontmatter: name e description
Due campi fanno quasi tutto il lavoro.
name è l’identificatore. Lo standard Agent Skills, la Claude API e claude.ai chiedono:
- al massimo 64 caratteri;
- solo lettere minuscole, numeri e trattini, senza trattino iniziale o finale e senza trattini doppi;
- nessuna parola riservata (“anthropic”, “claude”);
- per lo standard, lo stesso nome della cartella.
In Claude Code name è facoltativo: se manca, il comando prende il nome della cartella. Conviene metterlo comunque, così lo stesso file si può caricare su claude.ai o via API senza modifiche.
description è il campo più importante, perché è l’unica parte che Claude vede sempre ed è su questa che decide se attivare la skill. Deve dire cosa fa e quando usarla. Lo standard ammette al massimo 1.024 caratteri. In Claude Code il testo di description più when_to_use viene troncato a 1.536 caratteri nell’elenco delle skill, quindi il caso d’uso principale va all’inizio. Le best practice di Anthropic chiedono di scriverla in terza persona, perché finisce nel prompt di sistema e un punto di vista incoerente peggiora la scelta della skill.
I campi opzionali di Claude Code
Claude Code accetta molti campi in più. I più utili:
disable-model-invocation: true: solo tu puoi lanciare la skill con/nome, Claude non la attiva da solo. Serve per deploy, commit, invii.user-invocable: false: l’opposto. La skill sparisce dal menu/e la usa solo Claude. Serve per la conoscenza di sfondo.allowed-tools: strumenti che Claude può usare senza chiedere il permesso nel turno in cui la skill viene invocata. Il permesso decade al messaggio successivo.argument-hint: il suggerimento mostrato nell’autocompletamento, per esempio[percorso-csv].arguments: argomenti con nome, richiamabili nel corpo come$nome.when_to_use: frasi di attivazione aggiuntive, accodate alla description.modeledeffort: modello e livello di ragionamento mentre la skill è attiva.context: fork, conagent: esegue la skill in un subagent isolato, che non vede la conversazione.paths: pattern glob che limitano l’attivazione automatica ai file corrispondenti, per esempio**/*.php.shell:bash(predefinito) opowershellper i comandi eseguiti dentro la skill.hooks: hook registrati quando la skill viene invocata.
Due avvertenze della documentazione:
- un campo scritto male (un trattino al posto sbagliato, una maiuscola) viene ignorato in silenzio, senza errori;
- fuori da Claude Code (caricamento su claude.ai, Skills API) sono ammessi solo i sei campi dello standard:
name,description,license,compatibility,metadata,allowed-tools. Un campo in più, comeargument-hint, blocca il caricamento con l’erroreUnexpected key(s) in SKILL.md frontmatter.
Il corpo di SKILL.md
Regole pratiche, dalla documentazione e dai test:
- istruzioni, non spiegazioni: Claude sa già cos’è un title tag. Le best practice di Anthropic partono proprio da qui: Claude è già molto capace, aggiungi solo il contesto che non ha;
- workflow numerati per i compiti con passi in sequenza;
- meno di 500 righe: il resto va in file separati;
- gradi di libertà adeguati: testo libero dove più approcci sono validi, uno script dove il risultato deve essere sempre uguale;
- una sola strada predefinita: “usa questo script” funziona meglio di “puoi usare A, B o C”;
- le regole importanti in alto: dopo la compattazione di una conversazione lunga, Claude Code riallega solo i primi 5.000 token di ogni skill invocata.
Script e file di riferimento
Dal corpo di SKILL.md si rimanda agli altri file con link relativi, a un solo livello di profondità. Per gli script, Claude Code mette a disposizione la variabile ${CLAUDE_SKILL_DIR}, che punta alla cartella della skill qualunque sia la directory di lavoro: è il modo affidabile per lanciare uno script allegato.
Altre sostituzioni utili:
$ARGUMENTS: tutto quello che scrivi dopo il comando;$0,$1e successivi: i singoli argomenti;${CLAUDE_PROJECT_DIR}: la radice del progetto.
Esiste anche l’iniezione di contesto dinamico: una riga che inizia con ` !comando viene eseguita prima che Claude legga la skill e sostituita con il suo output. L'esempio della documentazione usa !git diff HEAD ` per avere il diff già dentro le istruzioni. Funziona solo in Claude Code, e se il comando fallisce si interrompe l’intera invocazione.
Dove si salvano le skill
La cartella in cui salvi la skill decide dove è disponibile.
| Livello | Percorso | Disponibile |
|---|---|---|
| Personale | ~/.claude/skills/nome/ | In tutti i tuoi progetti |
| Progetto | .claude/skills/nome/ | A chi lavora nel repo |
| Plugin | plugin/skills/nome/ | Dove il plugin è attivo |
| Enterprise | Impostazioni gestite | In tutta l’organizzazione |
- Le skill di progetto si versionano con git: chi clona il repository le riceve.
- Le skill dei plugin hanno uno spazio dei nomi (
/nome-plugin:nome-skill), quindi non entrano in conflitto con le altre. - Se due skill hanno lo stesso nome, enterprise vince su personale e personale vince su progetto. Una skill vince anche su un vecchio file
.claude/commands/con lo stesso nome. - Claude Code tiene d’occhio queste cartelle: una skill aggiunta o modificata è disponibile nella sessione in corso, senza riavviare. Fa eccezione una cartella skills creata a sessione già avviata, per la quale serve
/reload-skills. - Le skill personali non arrivano nelle sessioni cloud e in Cowork, che usano quelle abilitate sull’account claude.ai.
L’inventario completo di ~/.claude/, con backup e spostamento, è nella guida su memoria e configurazione di Claude Code.
Creare una skill passo per passo: seo-title-audit
L’obiettivo: dato l’export CSV di un crawl, ottenere un report con title e meta description mancanti, duplicati, troppo lunghi o troppo corti, e con gli H1 mancanti, duplicati, multipli o identici al title. Il formato di partenza è l’export Internal > HTML di Screaming Frog (internal_html.csv), ma lo script riconosce anche intestazioni generiche come url, title e meta description.
Perché una skill e non un prompt: il calcolo deve dare lo stesso risultato ogni volta. Lunghezze, duplicati normalizzati, esclusione dei redirect e delle pagine non indicizzabili li fa uno script. Claude trova il file, lancia lo script e commenta le priorità.
Passo 0: scrivi i test prima della skill
Anthropic raccomanda di scrivere le valutazioni prima delle istruzioni, così si risolvono problemi reali e non immaginari. Per questa skill ho fissato tre cose:
- tre prompt che devono attivarla, scritti come li scriverebbe un utente vero;
- due prompt che non devono attivarla: uno sullo stesso tema (scrivere un title) e uno sullo stesso file (contarne le righe);
- un CSV di prova con un caso per ogni controllo e il risultato atteso scritto prima di lanciare lo script.
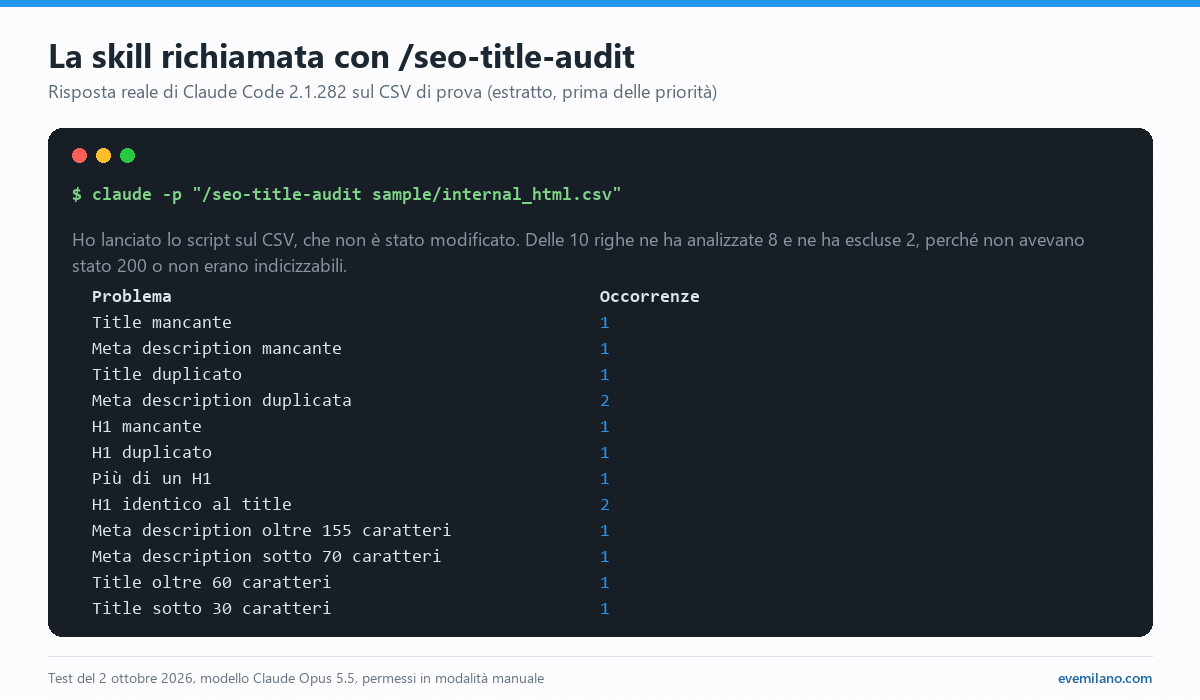
Il CSV ha 10 righe. Contiene un redirect 301 e una pagina tag non indicizzabile, che vanno escluse. Poi un title duplicato che differisce solo per maiuscole e spazi doppi, un H1 uguale al title salvo le maiuscole, un title di 8 caratteri, una meta description di 203 caratteri e una pagina con due H1.
Il primo giro ha dato un risultato diverso dall’atteso: lo script segnalava due gruppi di meta description duplicate, io ne aspettavo uno. Aveva ragione lo script. Nel CSV avevo riusato la stessa meta description su due pagine senza accorgermene, che è proprio l’errore che la skill deve intercettare.
Passo 1: crea la cartella
Per una skill personale (Git Bash su Windows, oppure macOS e Linux):
mkdir -p ~/.claude/skills/seo-title-audit/scripts ~/.claude/skills/seo-title-audit/referencesPer una skill di progetto, la stessa struttura va in .claude/skills/ nella radice del repository. Per i test ho usato questa seconda strada, in una cartella di progetto dedicata.
Passo 2: scrivi la description
La description decide se la skill scatta. La versione da evitare:
description: Aiuta con la SEOÈ troppo generica: Claude non sa quando usarla e rischia di attivarla su qualsiasi domanda SEO. La versione usata:
description: Controlla title, meta description e H1 a partire dall'export CSV di un crawler (Screaming Frog "Internal > HTML" o simili) e segnala elementi mancanti, duplicati, troppo lunghi o troppo corti e H1 identici al title. Da usare quando l'utente chiede di verificare title, meta description o H1 di un sito partendo da un crawl, o cita file come internal_html.csv.Cosa contiene:
- cosa fa, con le parole che l’utente scriverà davvero: title, meta description, H1, crawl, CSV, Screaming Frog;
- quando usarla, compreso un nome di file riconoscibile (
internal_html.csv); - terza persona: “Controlla”, non “Posso controllare”.
L’ho scritta in italiano perché in italiano saranno i prompt. Nei test ha funzionato al primo colpo: tutti e tre i prompt positivi l’hanno attivata, nessuno dei negativi.
Passo 3: scrivi le istruzioni
Il corpo di SKILL.md (il file completo è più sotto) fa sei scelte:
- il passo 1 usa
$ARGUMENTS: se lanci/seo-title-audit percorso.csv, il percorso arriva già dentro le istruzioni; - il passo 2 dice di eseguire lo script senza riscriverne la logica: senza questa frase Claude tende a rifare i conteggi da sé;
- il passo 2 indica anche quale strumento usare (Bash): su Windows Claude Code può scegliere PowerShell, che il permesso preapprovato non copre. L’ho aggiunto dopo averlo visto succedere nei test;
- il passo 3 gestisce l’errore più probabile, colonne con nomi diversi, facendo chiedere invece che indovinare;
- il passo 4 fissa il formato della risposta;
- le soglie e le loro motivazioni stanno in un file a parte, letto solo se l’utente lo chiede.
Passo 4: aggiungi lo script
scripts/audit.py usa solo la libreria standard di Python: chi installa la skill non deve installare nient’altro. Cosa fa:
- legge il CSV gestendo il BOM degli export di Screaming Frog e il separatore (virgola, punto e virgola di Excel in italiano, tabulazione);
- riconosce le colonne per nome, con alias;
- esclude le pagine con status diverso da 200 e quelle non indicizzabili, che in SERP non arrivano;
- confronta title, meta e H1 dopo averli normalizzati (maiuscole, spazi multipli, forme Unicode), così “Blog SEO” e “blog seo” risultano duplicati;
- stampa un report in markdown, oppure lo salva con
--out.
#!/usr/bin/env python3
"""Audit di title, meta description e H1 da un export CSV di un crawler.

Pensato per l'export "Internal > HTML" di Screaming Frog (internal_html.csv),
ma riconosce anche intestazioni generiche (url, title, meta description, h1).
Solo libreria standard: nessuna dipendenza da installare.

Uso:
    python audit.py internal_html.csv
    python audit.py internal_html.csv --title-max 65 --out report.md
"""

import argparse
import csv
import sys
import unicodedata
from collections import defaultdict

# Nomi di colonna accettati, in ordine di preferenza (confronto case-insensitive).
COLUMNS = {
    "url": ["address", "url", "page", "indirizzo"],
    "title": ["title 1", "title", "titolo"],
    "meta": ["meta description 1", "meta description", "description"],
    "h1": ["h1-1", "h1", "h1 1"],
    "h1_2": ["h1-2", "h1 2"],
    "status": ["status code", "status"],
    "indexability": ["indexability", "indicizzabilita", "indicizzabilità"],
}


def open_csv(path):
    """Legge il CSV gestendo BOM e separatore (virgola, punto e virgola o tab)."""
    for encoding in ("utf-8-sig", "cp1252"):
        try:
            with open(path, encoding=encoding, newline="") as f:
                text = f.read()
            break
        except UnicodeDecodeError:
            continue
    else:
        sys.exit(f"ERRORE: impossibile decodificare {path} (né UTF-8 né cp1252)")
    try:
        dialect = csv.Sniffer().sniff(text[:4096], delimiters=",;\t")
    except csv.Error:
        dialect = csv.excel
    return list(csv.DictReader(text.splitlines(), dialect=dialect))


def map_columns(fieldnames):
    """Associa i campi logici alle intestazioni reali del file."""
    lower = {name.strip().lower(): name for name in fieldnames if name}
    found = {}
    for key, aliases in COLUMNS.items():
        for alias in aliases:
            if alias in lower:
                found[key] = lower[alias]
                break
    return found


def norm(text):
    """Normalizza per il confronto: spazi, maiuscole e forme Unicode."""
    return " ".join(unicodedata.normalize("NFKC", text or "").split()).casefold()


def audit(rows, cols, args):
    get = lambda row, key: (row.get(cols[key]) or "").strip() if key in cols else ""
    issues = defaultdict(list)
    by_title, by_meta, by_h1 = defaultdict(list), defaultdict(list), defaultdict(list)
    skipped = 0

    for row in rows:
        url = get(row, "url")
        # Solo pagine 200 e indicizzabili: le altre non finiscono in SERP.
        status = get(row, "status")
        if status and status != "200":
            skipped += 1
            continue
        if not args.all and get(row, "indexability").lower() in ("non-indexable", "non indicizzabile"):
            skipped += 1
            continue

        title, meta, h1 = get(row, "title"), get(row, "meta"), get(row, "h1")

        if not title:
            issues["Title mancante"].append(url)
        else:
            by_title[norm(title)].append(url)
            if len(title) > args.title_max:
                issues[f"Title oltre {args.title_max} caratteri"].append(f"{url} ({len(title)})")
            elif len(title) < args.title_min:
                issues[f"Title sotto {args.title_min} caratteri"].append(f"{url} ({len(title)})")

        if not meta:
            issues["Meta description mancante"].append(url)
        else:
            by_meta[norm(meta)].append(url)
            if len(meta) > args.meta_max:
                issues[f"Meta description oltre {args.meta_max} caratteri"].append(f"{url} ({len(meta)})")
            elif len(meta) < args.meta_min:
                issues[f"Meta description sotto {args.meta_min} caratteri"].append(f"{url} ({len(meta)})")

        if "h1" in cols:
            if not h1:
                issues["H1 mancante"].append(url)
            else:
                by_h1[norm(h1)].append(url)
                if title and norm(h1) == norm(title):
                    issues["H1 identico al title"].append(url)
            if get(row, "h1_2"):
                issues["Più di un H1"].append(url)

    # Un duplicato è un gruppo di URL con lo stesso testo normalizzato.
    for label, groups in (("Title duplicato", by_title), ("Meta description duplicata", by_meta),
                          ("H1 duplicato", by_h1)):
        for urls in groups.values():
            if len(urls) > 1:
                issues[label].append(" | ".join(urls))

    return issues, len(rows) - skipped, skipped


def report(issues, analysed, skipped, cols, limit):
    order = ["Title mancante", "Meta description mancante", "Title duplicato",
             "Meta description duplicata", "H1 mancante", "H1 duplicato", "Più di un H1",
             "H1 identico al title"]
    labels = sorted(issues, key=lambda k: (order.index(k) if k in order else len(order), k))
    out = ["# Audit title, meta description e H1", "",
           f"Pagine analizzate: {analysed} (escluse {skipped} non 200 o non indicizzabili)", ""]
    if "h1" not in cols:
        out += ["Nota: colonna H1 assente, controlli H1 saltati.", ""]
    if not issues:
        return "\n".join(out + ["Nessun problema trovato."])
    out += ["| Problema | Occorrenze |", "|---|---|"]
    out += [f"| {k} | {len(issues[k])} |" for k in labels]
    for k in labels:
        out += ["", f"## {k}", ""]
        out += [f"- {item}" for item in issues[k][:limit]]
        if len(issues[k]) > limit:
            out.append(f"- … altri {len(issues[k]) - limit}")
    return "\n".join(out)


def main():
    p = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    p.add_argument("csv", help="export CSV del crawl")
    p.add_argument("--title-min", type=int, default=30)
    p.add_argument("--title-max", type=int, default=60)
    p.add_argument("--meta-min", type=int, default=70)
    p.add_argument("--meta-max", type=int, default=155)
    p.add_argument("--limit", type=int, default=20, help="righe di dettaglio per problema")
    p.add_argument("--all", action="store_true", help="includi le pagine non indicizzabili")
    p.add_argument("--out", help="scrive il report su file invece che a video")
    args = p.parse_args()

    try:
        rows = open_csv(args.csv)
    except FileNotFoundError:
        sys.exit(f"ERRORE: file non trovato: {args.csv}")
    if not rows:
        sys.exit("ERRORE: il CSV non contiene righe")
    cols = map_columns(rows[0].keys())
    missing = [k for k in ("url", "title", "meta") if k not in cols]
    if missing:
        sys.exit(f"ERRORE: colonne non trovate: {', '.join(missing)}. "
                 f"Intestazioni presenti: {', '.join(rows[0].keys())}")

    issues, analysed, skipped = audit(rows, cols, args)
    text = report(issues, analysed, skipped, cols, args.limit)
    if args.out:
        with open(args.out, "w", encoding="utf-8") as f:
            f.write(text + "\n")
        print(f"Report scritto in {args.out}")
    else:
        sys.stdout.reconfigure(encoding="utf-8")
        print(text)


if __name__ == "__main__":
    main()
Passo 5: aggiungi il file di riferimento
Le soglie dello script (30-60 caratteri per il title, 70-155 per la meta description) non sono regole di Google. Google Search Central lo dice esplicitamente: non c’è un limite alla lunghezza del <title>, il title link viene troncato quando serve per stare nella larghezza del dispositivo. Lo stesso vale per la meta description. Sono euristiche editoriali, e per questo stanno in un file separato con le loro motivazioni:
# Soglie dell'audit e perché

Google non fissa un limite di caratteri: "While there's no limit on how long a <title> element can be, the title link is truncated in Google Search results as needed, typically to fit the device width" (Google Search Central, Influencing your title links). Lo stesso vale per la meta description (Control your snippets in search results).

Le soglie sono quindi euristiche editoriali, modificabili da riga di comando:

| Controllo | Default | Opzione |
|---|---|---|
| Title corto | < 30 | `--title-min` |
| Title lungo | > 60 | `--title-max` |
| Meta corta | < 70 | `--meta-min` |
| Meta lunga | > 155 | `--meta-max` |

- Oltre 60 caratteri il title rischia il troncamento su desktop; il limite reale è in pixel e dipende dai caratteri usati.
- Sotto 30 caratteri il title spesso non descrive la pagina e Google tende a riscriverlo.
- La meta description non è un fattore di ranking: una meta lunga non è un errore, è solo testo che non si vedrà.
- "H1 identico al title" non è un errore: è un'occasione persa per coprire una variante della query.

Priorità consigliata: mancanti > duplicati > lunghezza > H1.
Il corpo della skill lo cita con un link relativo e una condizione (“se l’utente chiede perché una soglia vale X”). Finché la condizione non si verifica, il file non entra nel contesto.
Il SKILL.md completo
---
name: seo-title-audit
description: Controlla title, meta description e H1 a partire dall'export CSV di un crawler (Screaming Frog "Internal > HTML" o simili) e segnala elementi mancanti, duplicati, troppo lunghi o troppo corti e H1 identici al title. Da usare quando l'utente chiede di verificare title, meta description o H1 di un sito partendo da un crawl, o cita file come internal_html.csv.
argument-hint: "[percorso-csv]"
allowed-tools: Bash(python ${CLAUDE_SKILL_DIR}/scripts/audit.py *)
---

# Audit di title, meta description e H1

## Workflow

1. Individua il CSV: usa `$ARGUMENTS` se presente, altrimenti il file indicato dall'utente. Se non c'è, chiedilo.
2. Esegui lo script con lo strumento Bash (non PowerShell: il permesso preapprovato copre solo Bash), senza riscriverne la logica:
   `python ${CLAUDE_SKILL_DIR}/scripts/audit.py <percorso-csv>`
   Se l'utente chiede soglie diverse, aggiungi `--title-max`, `--title-min`, `--meta-max`, `--meta-min`.
3. Se lo script termina con `ERRORE: colonne non trovate`, riporta all'utente le intestazioni elencate e chiedi quale colonna usare. Non indovinare.
4. Rispondi con:
   - la tabella riepilogativa del report, così com'è;
   - le priorità raggruppate in quattro blocchi, in questo ordine: mancanti, duplicati, lunghezza, H1;
   - al massimo 3 URL di esempio per priorità.

## Regole

- Non modificare il CSV e non proporre nuovi title se l'utente non lo chiede.
- Le soglie sono euristiche, non limiti di Google. Se l'utente chiede perché una soglia vale X, o vuole cambiarla, leggi [references/soglie.md](references/soglie.md).
La riga allowed-tools segue lo schema indicato dalla documentazione per gli script allegati: la stessa variabile ${CLAUDE_SKILL_DIR} compare nel permesso e nel comando, così la regola corrisponde esattamente al comando che la skill fa eseguire. Nei test con i permessi in modalità manuale ha fatto la differenza: senza questa riga il comando dello script veniva bloccato, con la riga /seo-title-audit lo eseguiva senza chiedere conferma. Con l’invocazione automatica il comportamento è stato meno lineare, e i dettagli sono nella sezione sui test.
Come richiamare una skill
Invocazione automatica
Claude vede nome e descrizione di ogni skill disponibile. Quando una richiesta corrisponde, invoca la skill (in Claude Code è una chiamata allo strumento Skill), ne legge il corpo e segue le istruzioni. Nei test è successo con richieste formulate in modi diversi: “puoi controllare title e meta description?”, “controlla H1 e title duplicati”, “dammi le priorità SEO on-page partendo dall’export”. Nessuna citava il nome della skill.
Invocazione esplicita con /nome-skill
Scrivi / seguito dal nome, e dopo il nome gli argomenti:
/seo-title-audit sample/internal_html.csvIl testo dopo il nome diventa $ARGUMENTS. Se il corpo della skill non contiene segnaposto, Claude Code accoda comunque gli argomenti in fondo alle istruzioni come ARGUMENTS: <testo>. Gli argomenti con spazi vanno tra virgolette. Puoi anche impilare più skill in un messaggio: /write-tests /fix-issue 123 le carica entrambe e passa 123 a ciascuna.
Solo manuale o solo automatica
| Impostazione | Chi la lancia | Descrizione in contesto |
|---|---|---|
| Predefinita | Tu e Claude | Sempre |
disable-model-invocation: true | Solo tu | No |
user-invocable: false | Solo Claude | Sempre |
La regola della documentazione: le skill con effetti collaterali (deploy, commit, invio di messaggi) vanno rese solo manuali, perché non vuoi che Claude decida di pubblicare in produzione solo perché il codice sembra pronto. Se Claude prova comunque a invocarne una, Claude Code blocca la chiamata.
Puoi ottenere lo stesso effetto senza toccare il file, per esempio su una skill condivisa nel repository: nel menu /skills selezioni la skill e premi la barra spaziatrice per cambiarne lo stato, che viene salvato nell’impostazione skillOverrides.
Verificare che sia caricata
/skillselenca le skill disponibili, con la loro provenienza./contextmostra, alla riga Skills, quanto pesa l’elenco delle skill nel contesto.- In alternativa puoi chiedere a Claude quali skill ha a disposizione.
- Se l’attivazione automatica non funziona ma
/nomesì, il frontmatter probabilmente non viene letto:claude --debugmostra l’errore di parsing, eclaude plugin validate .claude/skillscontrolla tutti i frontmatter di una cartella. /skill-doctormostra quanto costa ogni skill e quanto spesso viene usata, per capire quali spegnere.
Testare e migliorare la skill
La documentazione di Claude Code lo dice in modo netto: vedere che una skill scatta ti dice che Claude l’ha trovata, non che ha fatto quello che volevi. Vanno misurate due cose separate: se si attiva sui prompt giusti, e se l’output è corretto quando si attiva.
I test di attivazione
Ho lanciato ogni prompt in una sessione nuova con claude -p dalla cartella del progetto di prova, con output in formato stream-json. Dal flusso degli eventi si legge se Claude chiama lo strumento Skill e quale comando esegue. La sessione nuova conta: il contesto rimasto dalla scrittura della skill nasconderebbe le lacune delle istruzioni.
Primo giro, con la versione iniziale della skill:
Prompt che devono attivarla
- “…puoi controllare title e meta description?”: skill attivata, script eseguito
- “Controlla H1 e title duplicati…”: skill attivata, script eseguito
- “Dammi le priorità SEO on-page…”: skill attivata, script eseguito
/seo-title-audit sample/internal_html.csv: skill eseguita, script eseguito
Prompt che non devono attivarla
- “Scrivimi un title SEO…”: nessuna skill
- “Quante righe ha il file…?”: nessuna skill, Claude usa
wc -l
Due note di lettura:
- con il comando esplicito la skill non passa dallo strumento
Skill, perché Claude Code ne espande il contenuto direttamente nel prompt. In quel caso il segnale da controllare è il comando eseguito; - per contare le righe del file Claude ha usato
wc -lsenza toccare la skill: una description che parla di title, meta e H1 non si sovrappone a una domanda generica sul file.
Sei risultati su sei come previsto, al primo giro. Ma un’attivazione corretta non garantisce un output corretto.
Cosa ho cambiato dopo i test
1. Una lacuna nello script. Al prompt “controlla H1 e title duplicati” la skill è scattata, ma lo script non controllava gli H1 duplicati. Claude se n’è accorto e ha compensato leggendo tutto il CSV: “Lo script non controlla gli H1 duplicati, quindi ho verificato a mano la colonna H1-1 del CSV”. Su 10 righe la risposta era giusta. Su un crawl da decine di migliaia di URL vuol dire caricare l’intero file nel contesto, cioè proprio quello che la skill deve evitare. Ho aggiunto allo script il controllo “H1 duplicato” e al CSV di prova il caso corrispondente (/blog/page/2/ con lo stesso H1 di /blog/).
2. Un’istruzione incoerente. Il corpo chiedeva “le 3 priorità” e poi ne elencava quattro: mancanti, duplicati, lunghezza, H1. In una risposta Claude l’ha fatto notare e ha deciso da sé di tenerle tutte. È il ciclo che le best practice di Anthropic descrivono come “Claude A e Claude B”: chi scrive la skill non vede le proprie ambiguità, un’istanza con il contesto pulito sì. Ho corretto il testo in “quattro blocchi”.
3. I permessi. Il primo giro girava in modalità auto, in cui un classificatore approva da solo i comandi ritenuti sicuri: lì allowed-tools non fa differenza, e infatti lo script partiva anche togliendo quella riga. Ripetendo i test con i permessi in modalità manuale (--permission-mode default) il quadro cambia:
- senza
allowed-toolsil comando dello script veniva bloccato, sia con/seo-title-auditsia con l’invocazione automatica. Claude si fermava senza rifare i calcoli a mano, come chiede il passo 2; - con
allowed-tools,/seo-title-auditha eseguito lo script senza richieste in tutti i tentativi; - con l’invocazione automatica in modalità non interattiva il primo ostacolo è lo strumento
Skillstesso, che nella tabella degli strumenti di Claude Code richiede un permesso. Consentita la skill con--allowedTools "Skill(seo-title-audit)", Claude su Windows ha usato in un caso lo strumento PowerShell, che una regolaBash(...)non copre: da qui l’istruzione esplicita nel passo 2; - anche dopo questa correzione, in 4 invocazioni automatiche su 6 il comando dello script è stato negato, pur essendo identico carattere per carattere a quello consentito negli altri casi. La documentazione non spiega questo comportamento e lo riporto come osservazione. In una sessione interattiva si traduce al massimo in una richiesta di conferma; in uno script non interattivo conviene aggiungere una regola di permesso esplicita per il comando.
Dopo le correzioni ho rilanciato da capo il controllo dello script sul CSV di prova e i sei prompt. Lo script dà esattamente l’output atteso, i tre prompt positivi attivano la skill, i due negativi no, e sul prompt degli H1 Claude usa lo script invece di leggere il file.
Confronto con e senza skill, e skill-creator
Il controllo più rigoroso è la baseline: stessi prompt, una volta con la skill e una volta con la skill spenta (impostandola su "off" in skillOverrides), confrontando i risultati.
Per automatizzare il ciclo Anthropic distribuisce il plugin skill-creator:
/plugin install skill-creator@claude-plugins-officialCosa fa:
- salva casi di test e risultati attesi in
evals/evals.json, dentro la cartella della skill; - esegue ogni caso in un subagent con contesto pulito;
- assegna un esito a ogni verifica, superata o fallita;
- confronta tasso di successo, tempi e token con e senza skill;
- mette a confronto alla cieca due versioni della skill;
- genera prompt che dovrebbero attivare la skill e prompt che non dovrebbero, e propone correzioni alla description.
Le best practice di Anthropic suggeriscono anche di provare la skill con tutti i modelli su cui la userai: istruzioni che bastano a Opus possono risultare troppo scarne per Haiku.
La stessa skill su claude.ai e via API
claude.ai
Le skill personalizzate si caricano come file zip dalle impostazioni di claude.ai. Sono disponibili nei piani Pro, Max, Team ed Enterprise con l’esecuzione di codice attiva, e restano individuali: ogni utente carica le sue.
Per portarci seo-title-audit servono due modifiche:
- togliere
argument-hintdal frontmatter, perché fuori da Claude Code sono ammessi solo i sei campi dello standard; - riscrivere il comando dello script senza
${CLAUDE_SKILL_DIR}e$ARGUMENTS, che sono sostituzioni di Claude Code.
Claude API
Via API le skill si passano nel parametro container della Messages API, insieme allo strumento di esecuzione del codice, fino a 20 skill per richiesta. Quelle personalizzate si caricano con gli endpoint /v1/skills (massimo 30 MB non compressi) e sono condivise in tutto il workspace. La Skills API non è più in beta e non richiede header dedicati.
L’ambiente di esecuzione dell’API non ha accesso alla rete e non permette di installare pacchetti. Uno script che usa solo la libreria standard, come audit.py, non ha problemi; uno che chiama un’API esterna non funzionerà.
Le skill non si sincronizzano tra ambienti
Una skill caricata su claude.ai non compare nell’API, e viceversa. Le skill di Claude Code sono file su disco, separati da entrambi. L’unico ponte: se accedi a Claude Code con un account claude.ai, le skill abilitate sull’account vengono scaricate in ~/.claude/skills/synced/ e compaiono in /skills sotto “claude.ai sync”. Il percorso inverso non esiste: modificare quei file in locale non aggiorna l’account.
Lo standard aperto Agent Skills
Il formato è pubblicato come standard aperto su agentskills.io, e la documentazione di Claude Code dice che lo segue e lo estende. La specifica definisce i sei campi del frontmatter, le cartelle convenzionali e un validatore (skills-ref validate ./nome-skill). In pratica: una skill che usa solo i campi dello standard è il formato più portabile, sia tra le superfici di Anthropic sia verso gli altri prodotti che adottano il formato, elencati sul sito dello standard.
Errori frequenti
- La skill non scatta. La description è troppo generica o non contiene le parole che usi nei prompt. Altre cause: le
---del frontmatter non sono sulla prima riga del file, oppure la skill sta in una sottocartella del progetto e non viene caricata finché Claude non lavora su file di quella cartella. - Con
/nomefunziona, in automatico no. Il YAML non è valido: Claude Code carica comunque la skill, ma senza campi, quindi senza description. Si vede conclaude --debug. - Un campo non ha effetto. È scritto male e Claude Code lo ignora senza segnalarlo. I nomi vanno scritti esattamente come in documentazione, con i trattini (
when_to_useè l’unica eccezione con il trattino basso). - La skill scatta troppo spesso. Rendi la description più specifica, limita l’attivazione con
pathso rendila solo manuale condisable-model-invocation: true. - Claude smette di seguirla a metà sessione. Dopo una compattazione la skill viene riallegata solo in parte: invocala di nuovo. Se una regola deve valere sempre, spostala in un hook.
- Le descrizioni vengono tagliate. Con molte skill installate l’elenco supera il budget (l’1% della finestra di contesto) e Claude Code toglie le descrizioni delle skill meno usate.
/doctorstima il costo dell’elenco,/skill-doctorindica quali skill spegnere. - Percorsi Windows. Nei riferimenti dentro la skill usa sempre la barra
/, anche su Windows: con\i percorsi si rompono sui sistemi Unix. - Su Windows il permesso preapprovato non scatta. Claude Code può eseguire i comandi con lo strumento PowerShell, e una regola
Bash(...)inallowed-toolsnon lo copre. Indica nelle istruzioni quale strumento usare. - Il caricamento su claude.ai fallisce. C’è un campo che lo standard non prevede: l’errore
Unexpected key(s)dice quale. - Nomi riservati. Una cartella chiamata
synced, o un nome che inizia conanthropic-skills, non viene caricata: sono riservati alle skill sincronizzate da claude.ai.
Sicurezza
Una skill è software: istruzioni più codice eseguito con i tuoi permessi. La documentazione di Anthropic chiede di usare solo skill create da te o fornite da Anthropic, e di trattare le altre come un programma da installare.
- Leggi tutti i file prima di installare:
SKILL.md, script, risorse. Cerca chiamate di rete, accessi a file o operazioni che non c’entrano con lo scopo dichiarato. - Diffida delle skill che scaricano contenuti da URL esterni: quel contenuto può contenere istruzioni malevole, e una skill affidabile oggi può diventare pericolosa se cambia la fonte da cui legge.
- Controlla
allowed-toolsnei repository che cloni. Claude Code applica gliallowed-toolsdelle skill di progetto anche in cartelle mai marcate come affidabili, quindi una skill può concedersi da sola accessi ampi. Rivedi quel campo prima di avviare Claude Code in un repository di terzi. - Blocca quello che non vuoi: le regole di permesso accettano
Skill(nome)per consentire o negare skill specifiche, e l’impostazionedisableSkillShellExecutionimpedisce l’esecuzione dei comandi `!… - Dati e conservazione: lato API le skill non rientrano negli accordi di zero data retention.
Checklist operativa
- Scrivi tre prompt che devono attivare la skill e due che non devono.
- Prepara dati di prova con un caso per ogni controllo e il risultato atteso scritto prima.
- Crea la cartella in
~/.claude/skills/(personale) o.claude/skills/(progetto). - Scrivi
name(minuscole e trattini, uguale alla cartella) edescription(cosa fa + quando usarla, in terza persona, con le parole dei tuoi prompt). - Scrivi il corpo come workflow numerato, sotto le 500 righe, con le regole importanti in alto.
- Sposta i calcoli deterministici in uno script e richiamalo con
${CLAUDE_SKILL_DIR}. - Sposta il materiale di consultazione in file separati, citati con una condizione d’uso.
- Decidi chi può lanciarla: entrambi, solo tu (
disable-model-invocation) o solo Claude (user-invocable: false). - Verifica che compaia in
/skills. - Lancia i prompt di test in sessioni nuove e registra attivazione e output.
- Correggi description e istruzioni sulla base di ciò che vedi, non di ciò che immagini.
- Se la porti su claude.ai o API, riduci il frontmatter ai sei campi dello standard.
Se vuoi portarlo in azienda
Trasformare le procedure di un team in skill, decidere cosa va nel CLAUDE.md, cosa in un server MCP e cosa in un hook, e misurare se il risultato regge: sono i temi pratici del corso sull’utilizzo dell’AI in azienda.
Fonti
- Anthropic, Extend Claude with skills (documentazione di Claude Code)
- Anthropic, Agent Skills: overview
- Anthropic, Skill authoring best practices
- Anthropic, Using Agent Skills with the API
- Anthropic Engineering, Equipping agents for the real world with Agent Skills
- Agent Skills, Specification
- Anthropic, repository anthropics/skills
- Google Search Central, Influencing your title links e Control your snippets in search results
Autore
Mi chiamo Giovanni Sacheli e dal 2009 aiuto le aziende a farsi trovare online. Sono specializzato in SEO tecnica e PPC, competenze che applico quotidianamente nella mia agenzia, Searcus Swiss Sagl. Mi piace sviluppare strumenti a supporto del mio lavoro, ho creato SEOdata.app e cluster.army e co-scritto il libro SEO Audit Avanzato. Curo maniacalmente questo blog per colleghi e appassionati, dove mi "appunto" quello che imparo. Sono un NERD anni '80, motociclista e orgoglioso papà di due bambini.
Link:
Giovanni Sacheli
SEO Audit Avanzato
Searcus Swiss Sagl
SEOdata.app
cluster.army