

WebMCP è una proposta di standard web con cui una pagina dichiara agli agenti AI che lavorano nel browser quali azioni mette a disposizione: cercare, filtrare, compilare un modulo, leggere lo stato di un carrello.
Ogni azione è un tool con un nome, una descrizione in linguaggio naturale e uno schema JSON dei parametri. L’agente non deve più dedurre dal DOM quale bottone premere: chiama la funzione e riceve un risultato strutturato. Chrome lo sta sperimentando in origin trial, ChatGPT lo usa già nel browser della sua app desktop e la specifica del W3C è stata aggiornata il 13 novembre 2026. Chi gestisce un sito con funzioni interattive ha quindi già oggi gli strumenti per provarlo, e il momento giusto per capire come funziona è prima che gli agenti nel browser diventino un canale di traffico.
Questa guida copre lo stato dell’arte, le due API (imperativa e dichiarativa), il metodo per implementarle, la sicurezza e l’impatto reale sulla SEO. Gli esempi di codice vengono dalla documentazione ufficiale di Chrome e di OpenAI e da un plugin WordPress che ho scritto e testato in Chrome per esporre due tool di sola lettura.
WebMCP in breve: cosa risolve
Il limite dell’actuation
Oggi un agente che opera su un sito lavora per actuation: la documentazione Chrome la definisce come l’atto di simulare clic e digitazione come se l’agente fosse l’utente (Chrome for Developers, WebMCP). Per completare una ricerca l’agente deve trovare il campo giusto nel DOM o in uno screenshot, scrivere la query, interpretare la pagina dei risultati e decidere dove cliccare. Ogni passaggio è un’inferenza, e ogni inferenza può sbagliare. Se il layout cambia, il percorso che funzionava ieri può rompersi oggi. Chi ha lavorato su siti JavaScript conosce bene il problema di ciò che un client automatico legge davvero di una pagina: è lo stesso tema affrontato nell’articolo su cosa leggono i chatbot delle pagine JavaScript, con la differenza che qui l’agente non si limita a leggere, ma agisce.
Il sito dichiara i propri tool
WebMCP inverte il rapporto: invece di lasciare che l’agente interpreti l’interfaccia, è il sito a dichiarare lo scopo delle proprie funzioni. Un tool WebMCP ha tre elementi:
- un nome univoco, per esempio
search_productsoget_order_status; - una descrizione che spiega cosa fa il tool e quando conviene usarlo;
- uno schema JSON dei parametri in ingresso (
inputSchema) e, facoltativamente, del risultato (outputSchema).
L’agente vede l’elenco dei tool della scheda, sceglie quello adatto alla richiesta dell’utente, lo chiama e riceve il risultato. Il tool viene eseguito dentro la pagina, con la sessione dell’utente, e il suo effetto resta visibile nell’interfaccia.
Cosa offre in concreto
La documentazione Chrome riassume il valore di WebMCP in tre punti:
- Discovery: un modo standard per una pagina di registrare i propri tool presso gli agenti.
- Schemi JSON: definizioni esplicite di input e output, per ridurre allucinazioni e fraintendimenti.
- Stato condiviso: l’agente sa quali risorse sono disponibili nella pagina in quel momento.
C’è un vantaggio meno evidente ma decisivo per chi mantiene un sito: i tool imperativi sono collegati alla logica applicativa, non al layout. Un redesign non rompe la capacità dell’agente di usare il sito (When to use WebMCP and MCP). Per capire meglio come un agente ragiona e dove tende a sbagliare, è utile la guida sulla programmazione agentica.
A che punto è (novembre 2026)
La specifica W3C
WebMCP è sviluppato nel W3C Web Machine Learning Community Group. Lo stato del documento è Draft Community Group Report e la versione corrente è del 13 novembre 2026 (specifica WebMCP). Non è uno standard W3C approvato: è una bozza di un Community Group, quindi interfacce e nomi possono ancora cambiare. L’API è esposta su document.modelContext e ruota attorno a tre metodi: registerTool(), getTools() ed executeTool().
Una nota per chi ha letto le guide uscite nel 2025, compresa la mia analisi del check WebMCP di isitagentready: le prime descrizioni di WebMCP citavano navigator.modelContext.provideContext(). Quel metodo non compare più né nella specifica né nella documentazione Chrome. Il codice scritto su quella base va aggiornato a document.modelContext.registerTool().
Chrome: dev trial, origin trial e flag
Secondo ChromeStatus, WebMCP è in dev trial da Chrome 146 e in origin trial da Chrome 149 a 156, periodo poi esteso fino a Chrome 162. La console di registrazione dell’origin trial indica il 30 marzo 2027 come data di fine. Lo stato della funzione in Chrome è “Proposed”.
In pratica ci sono due modi per avere l’API attiva:
- in produzione, iscrivendo il proprio dominio all’origin trial e inserendo il token nelle pagine: l’API si attiva per i visitatori che usano Chrome 149 o successivo;
- in sviluppo locale, attivando il flag
chrome://flags/#enable-webmcp-testinge riavviando il browser (Chrome for Developers, WebMCP).
Le versioni contano, perché alcune parti dell’API sono arrivate dopo l’inizio del trial: outputSchema è disponibile da Chrome 159, l’annotazione debugging da Chrome 156, la rimozione di un tool senza interrompere le esecuzioni in corso da Chrome 153; il passaggio degli argomenti come stringa JSON è deprecato da Chrome 155 (Imperative API).
ChatGPT: i Site tools nel browser dell’app desktop
OpenAI chiama la propria implementazione “Site tools” e la descrive esplicitamente come implementazione della proposta WebMCP (ChatGPT Learn, Site tools). I punti da conoscere:
- oggi i Site tools funzionano solo nel browser integrato dell’app desktop di ChatGPT, usato da ChatGPT Work e Codex;
- l’utente vede i tool offerti dalla pagina dalla barra degli indirizzi, alla voce Site tools;
- ogni chiamata passa da un controllo di sicurezza del browser prima che il sito la esegua, e restano valide le normali conferme per le azioni rilevanti (inviare messaggi, acquistare, cancellare dati, cambiare permessi);
- l’utente può disattivarli in Impostazioni > Browser > Autorizzazioni.
OpenAI tratta le definizioni e i risultati dei tool come contenuto non affidabile: il fatto che un tool dichiari di leggere soltanto non è considerato una prova di ciò che fa. È un’impostazione da tenere presente quando si progettano le descrizioni.
Firefox, Safari, Edge: cosa non sappiamo
Nelle fonti ufficiali consultate non ci sono annunci su WebMCP da parte di Mozilla, Apple o Microsoft. Non ha senso fare ipotesi: oggi l’unico browser con l’API in trial pubblico è Chrome, e l’unico agente di un grande fornitore che la usa in modo documentato è quello di ChatGPT desktop. Anche per Gemini in Chrome le fonti non dicono che usi i tool WebMCP: le estensioni di test di Google, anzi, sono dichiarate come separate da Gemini in Chrome.
WebMCP e MCP: sono due cose diverse
Il nome trae in inganno: WebMCP non è un’estensione del Model Context Protocol né lo sostituisce. Google usa un’analogia efficace: MCP è un call center, raggiungibile ovunque e in qualsiasi momento; WebMCP è un esperto in negozio, disponibile solo mentre l’utente è sulla pagina (When to use WebMCP and MCP). Se si parte da zero su MCP, conviene leggere prima la spiegazione di cos’è un server MCP e la guida pratica ai server MCP.
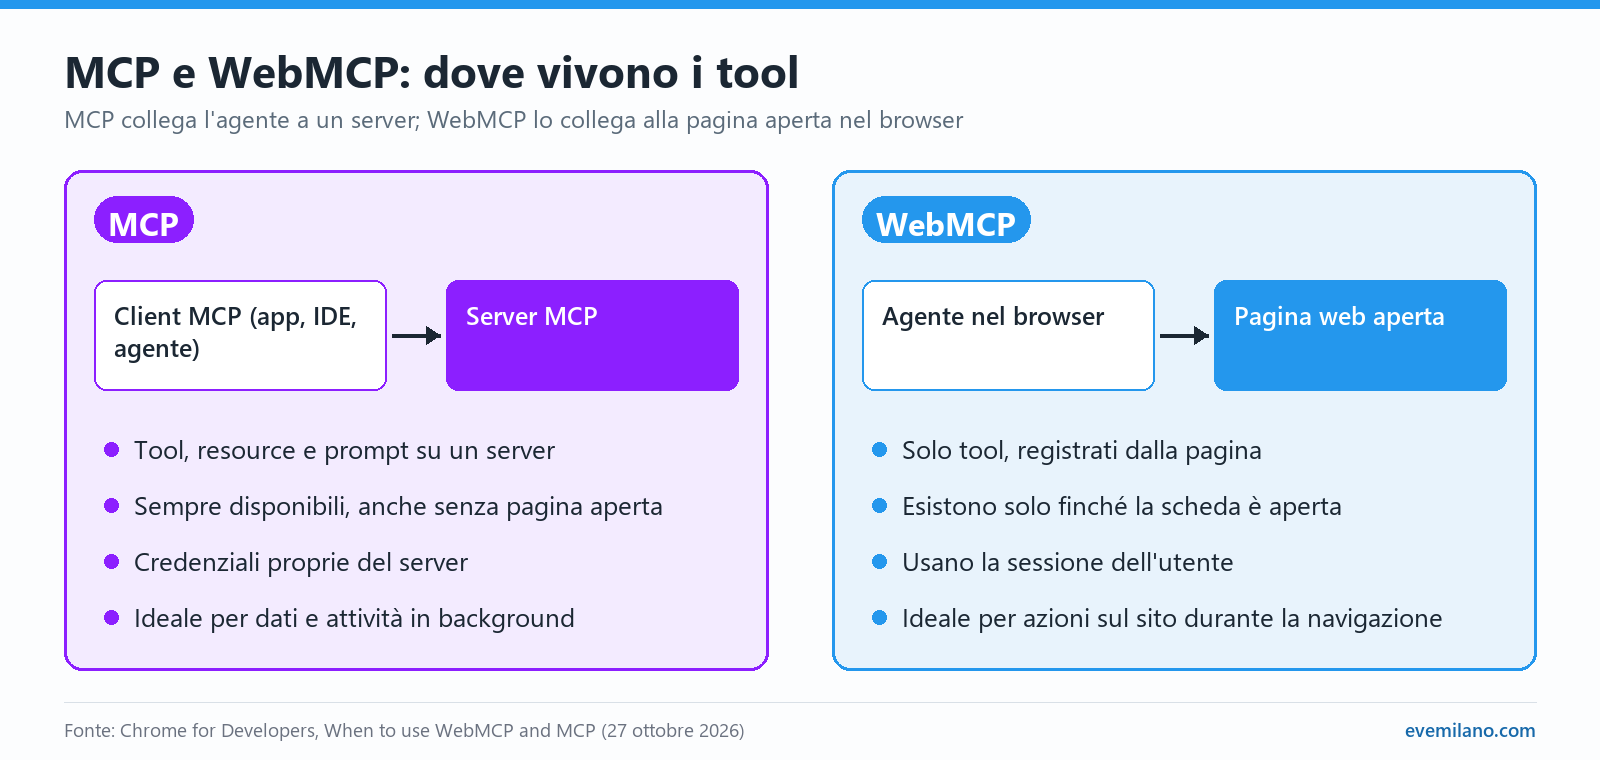
| Aspetto | MCP | WebMCP |
|---|---|---|
| Dove vivono i tool | Su un server | Nella pagina web |
| Chi li chiama | Qualsiasi client MCP | Un agente con accesso alla pagina renderizzata |
| Quando sono disponibili | Finché il server è attivo | Solo a pagina aperta |
| Quale login usano | Credenziali proprie | La sessione dell’utente |
| Componenti | Tool, resource, prompt | Solo tool |
| Uso migliore | Attività in background, accesso ai dati | Azioni sul sito durante la navigazione |
Quando usare l’uno, l’altro o entrambi
La differenza sostanziale è dove vive la funzione. MCP è un protocollo basato su JSON-RPC 2.0, implementato con SDK per diversi linguaggi, che collega un agente (nel browser o no) a sistemi esterni. WebMCP è un insieme di API “ispirate a MCP” pensate per il browser, che omettono concetti lato server come le resource.
Le due tecnologie si combinano bene:
- MCP per la logica di base: un server MCP gestisce dati, logica di business e attività in background, ed è disponibile per qualsiasi agente anche senza una pagina aperta.
- WebMCP per il contesto: quando l’utente è sul sito, l’agente agisce sulla stessa interfaccia che l’utente vede, con la sua sessione.
OpenAI fa lo stesso ragionamento: WebMCP è utile quando utente e agente devono vedere la stessa cosa, per esempio una dashboard o un editor; un plugin con server MCP serve quando l’integrazione deve funzionare senza una pagina aperta (ChatGPT Learn, Site tools).
Un dettaglio operativo che cambia il modo di pensare i tool: sono effimeri. Esistono solo finché la pagina è aperta; se l’utente cambia pagina o chiude la scheda, spariscono.
API imperativa: registrare un tool in JavaScript
L’API imperativa permette di definire qualsiasi tipo di tool con JavaScript standard: ricerche, navigazione, gestione dello stato dell’applicazione, compilazione di moduli.
Struttura minima di un tool
La registrazione richiede nome, descrizione, schema di input e la funzione execute. Questo è l’esempio della demo WebMCPza Maker riportato nella guida all’API imperativa:
await document.modelContext.registerTool({
  name: 'toggle_layer',
  description: 'Control pizza layers (sauce, cheese). Use "add", "remove", or "toggle".',
  inputSchema: {
    type: 'object',
    properties: {
      layer: { type: 'string', enum: ['sauce-layer', 'cheese-layer'] },
      action: { type: 'string', enum: ['add', 'remove', 'toggle'] },
    },
    required: ['layer'],
  },
  execute: async ({ layer, action }) => {
    await toggleLayer(layer, action);
    return `Performed ${action || 'toggle'} on layer: ${layer}`;
  },
});
Vale la pena notare due scelte. I valori ammessi sono vincolati con enum, così l’agente non deve indovinare il formato. E la funzione execute richiama la logica che l’applicazione usa già (toggleLayer): il tool è un’interfaccia nuova su codice esistente, non una seconda implementazione.
Annotazioni: quando usare ciascuna
Il campo annotations descrive le caratteristiche di sicurezza del tool. Tutte le annotazioni sono booleane e valgono false se omesse:
readOnlyHint: il tool legge informazioni senza modificare lo stato, come la ricerca in un catalogo. Aiuta l’agente a capire quando non serve chiedere conferma.untrustedContentHint: il risultato contiene dati che l’autore del tool non controlla, come recensioni, commenti o contenuti esterni. Segnala all’agente che il payload va trattato con più cautela per ridurre il rischio di prompt injection indiretto.consequentialHint: il tool produce azioni rilevanti o irreversibili, come prenotare un volo, trasferire denaro o cancellare dati. Permette ad agente e browser di imporre una conferma dell’utente prima dell’esecuzione.debugging(da Chrome 156): il tool è pensato per il debug e gli strumenti per sviluppatori, non per l’utente finale. Gli agenti generici possono escluderlo.
Le annotazioni sono segnali, non controlli di sicurezza. La guida Chrome è esplicita: autorizzazioni, identificativi e sequenze vanno verificati nella logica applicativa, oltre readOnlyHint e untrustedContentHint (Build your user’s agentic workflows).
outputSchema (da Chrome 159)
Da Chrome 159 si può dichiarare lo schema JSON del valore restituito. Le indicazioni di Google sono pragmatiche:
- la descrizione resta breve e spiega cosa fa il tool e quando chiamarlo; nomi e tipi dei campi restituiti vanno nello schema, non nel testo;
outputSchemaserve sui tool di lettura o ricerca che restituiscono più campi e su quelli che restituiscono ID da usare in chiamate successive; si omette sulle letture semplici, sulle azioni che modificano dati e sui tool di navigazione, per risparmiare token;execute()deve restituire un valore serializzabile in JSON coerente con lo schema: l’agente può validarlo e segnalare un errore al modello se non corrisponde.
Rimuovere un tool e gestire l’annullamento
Un tool si rimuove passando un AbortSignal a registerTool() e chiamando abort() sul controller quando il tool non serve più. Da Chrome 153 la rimozione non interrompe le esecuzioni già in corso, un dettaglio importante per i framework a componenti che montano e smontano parti dell’interfaccia.
La funzione execute riceve come secondo argomento un oggetto con la proprietà signal. Va passato alle operazioni lunghe, in particolare a fetch(), così che l’annullamento da parte dell’utente o dell’agente fermi davvero la richiesta. Estratto dalla guida all’API imperativa:
  execute: async ({ url, priority }, { signal }) => {
    // Abort the fetch request when tool execution is aborted.
    const response = await fetch(url, { priority, signal });
Infine, l’evento toolchange su document.modelContext avvisa quando l’elenco dei tool disponibili cambia.
Iframe di altri domini: allow="tools", exposedTo, fromOrigins
Entrambe le API sono soggette alla Permissions Policy tools, che per impostazione predefinita vale self: la registrazione è permessa nella pagina principale e nei contesti dello stesso dominio, ed è disattivata negli iframe di altri domini. Per abilitarla in un iframe esterno serve l’attributo allow="tools":
<iframe src="https://example.com" allow="tools"></iframe>La visibilità tra domini diversi ha due chiavi, entrambe necessarie:
- chi registra il tool elenca in
exposedTole origini sicure a cui lo rende visibile; - chi lo vuole usare elenca in
fromOrigins, nella chiamata agetTools(), le origini da cui accetta tool.
Senza fromOrigins, getTools() restituisce solo i tool della stessa origine. Il browser integrato di ChatGPT, dal canto suo, scopre i tool nella pagina principale e negli iframe dello stesso dominio e di altri domini, a patto che ogni frame sia un contesto sicuro, e per la sola scoperta da parte dell’agente non richiede exposedTo (ChatGPT Learn, Site tools).
API dichiarativa: trasformare un form in un tool
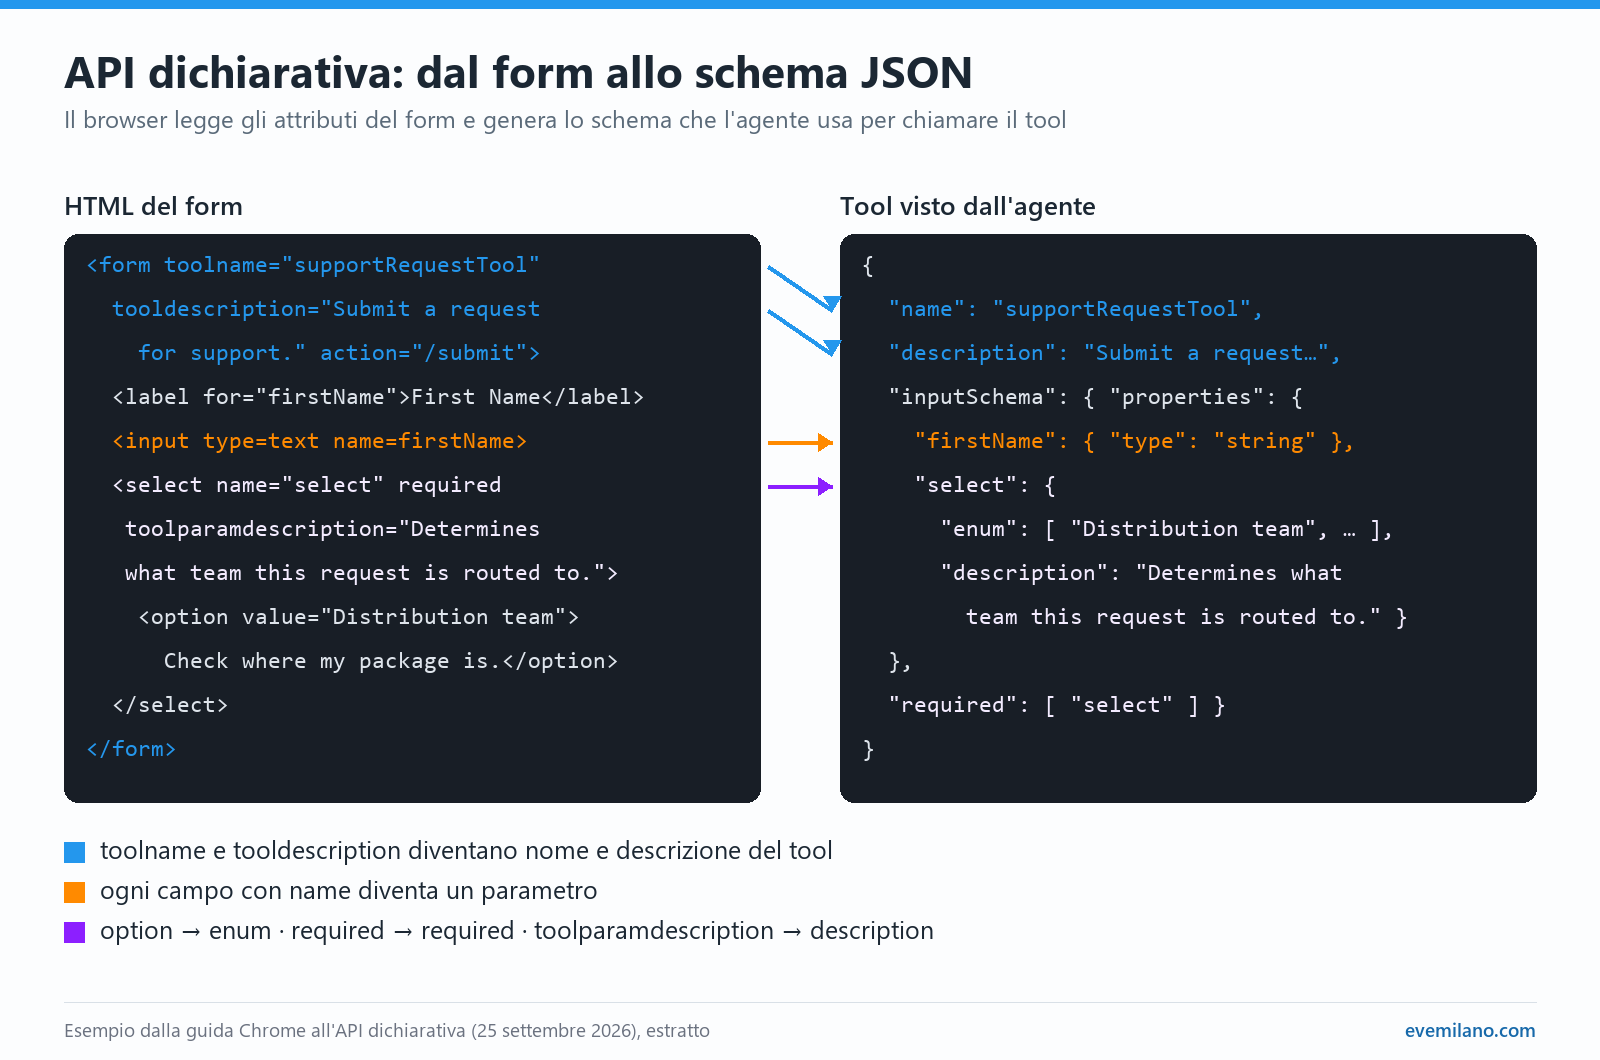
L’API dichiarativa trasforma un form HTML esistente in un tool aggiungendo attributi. Il form diventa il tool, i suoi campi diventano i parametri. È la strada più rapida quando l’azione che si vuole esporre è già un modulo.
Gli attributi del form
Due attributi sul <form> sono obbligatori (Declarative API):
toolname: il nome del tool;tooldescription: cosa fa e a cosa serve.
Se uno dei due viene rimosso, il tool non è più registrato. Questo permette di gestire la disponibilità in modo dinamico, aggiungendo o togliendo gli attributi in base allo stato della pagina.
Sui singoli campi si può aggiungere toolparamdescription, che diventa la descrizione del parametro nello schema JSON.
Come il browser costruisce lo schema dai campi
Il browser legge il form e genera lo schema: il name di ogni campo diventa una proprietà, le <option> di una <select> diventano valori ammessi, l’attributo required finisce nell’elenco dei campi obbligatori. In assenza di toolparamdescription, il browser usa il testo del <label> associato e, se manca anche quello, l’aria-description.
Ne deriva una regola pratica: un form accessibile, con label corrette, produce già uno schema leggibile per l’agente. Chi ha curato l’accessibilità del markup parte avvantaggiato.
Invio manuale o automatico, agentInvoked e respondWith()
Quando l’agente chiama il tool, il browser porta il form in primo piano e compila i campi; il form resta visibile all’utente. Per l’invio ci sono due possibilità:
- invio manuale: è l’utente a premere il pulsante, che è il comportamento predefinito;
- invio automatico: con l’attributo
toolautosubmitil form viene inviato quando il modello invoca il tool.
Nell’evento di submit, la proprietà agentInvoked dice se l’invio è partito da un agente. Il metodo respondWith() permette di restituire al modello un risultato, dopo aver chiamato preventDefault(). Estratto dalla guida Chrome:
<form toolautosubmit toolname="search_tool"
  tooldescription="Search the web" action="/search">
  <input type=text name=query>
</form>
<script>
  document.querySelector("form").addEventListener("submit", (e) => {
    e.preventDefault();
    if (!myFormIsValid()) {
      if (e.agentInvoked) { e.respondWith(myFormValidationErrorPromise) };
      return;
    }
    if (e.agentInvoked) { e.respondWith(Promise.resolve("Search is done!")); }
  });
</script>
Gli eventi toolactivated e toolcancel su document.modelContext segnalano rispettivamente che l’agente ha compilato il form e che l’operazione è stata annullata. Le proprietà window.ontoolactivated e window.ontoolcancel non sono supportate da Chrome 156: si usa addEventListener su document.modelContext. Le pseudo-classi CSS :tool-form-active e :tool-submit-active permettono di evidenziare il form e il pulsante mentre l’agente li sta usando, così l’utente vede cosa succede.
Quali form non esporre
Non tutti i form esistenti sono buoni candidati, e il motivo sta proprio nel modo in cui il browser costruisce lo schema: ogni campo con un name può diventare un parametro. Prima di aggiungere toolname conviene controllare tre cose.
- Campi tecnici nascosti. Un campo honeypot anti-spam, pensato per essere ignorato dagli umani e compilato dai bot, finisce tra i parametri del tool. Nel migliore dei casi confonde l’agente, nel peggiore viene compilato e la richiesta viene scartata come spam.
- Consensi. Una casella di consenso privacy o marketing deve riflettere una scelta dell’utente. Se è un parametro del tool, l’agente può spuntarla al suo posto. Va tolta dal tool e lasciata all’utente, oppure il form non va esposto.
- Azioni irreversibili. Un form di acquisto, cancellazione o invio di dati a terzi non dovrebbe usare
toolautosubmit. L’invio manuale lascia la conferma all’utente.
Un form di contatto tipico ha spesso tutti e tre i problemi insieme. In quel caso l’API imperativa, con parametri scelti uno per uno, è la soluzione più pulita.
Implementare WebMCP passo per passo
Le due API sono semplici; la difficoltà sta nelle scelte. Questo è l’ordine di lavoro che consiglio, con il ragionamento dietro ogni passaggio.
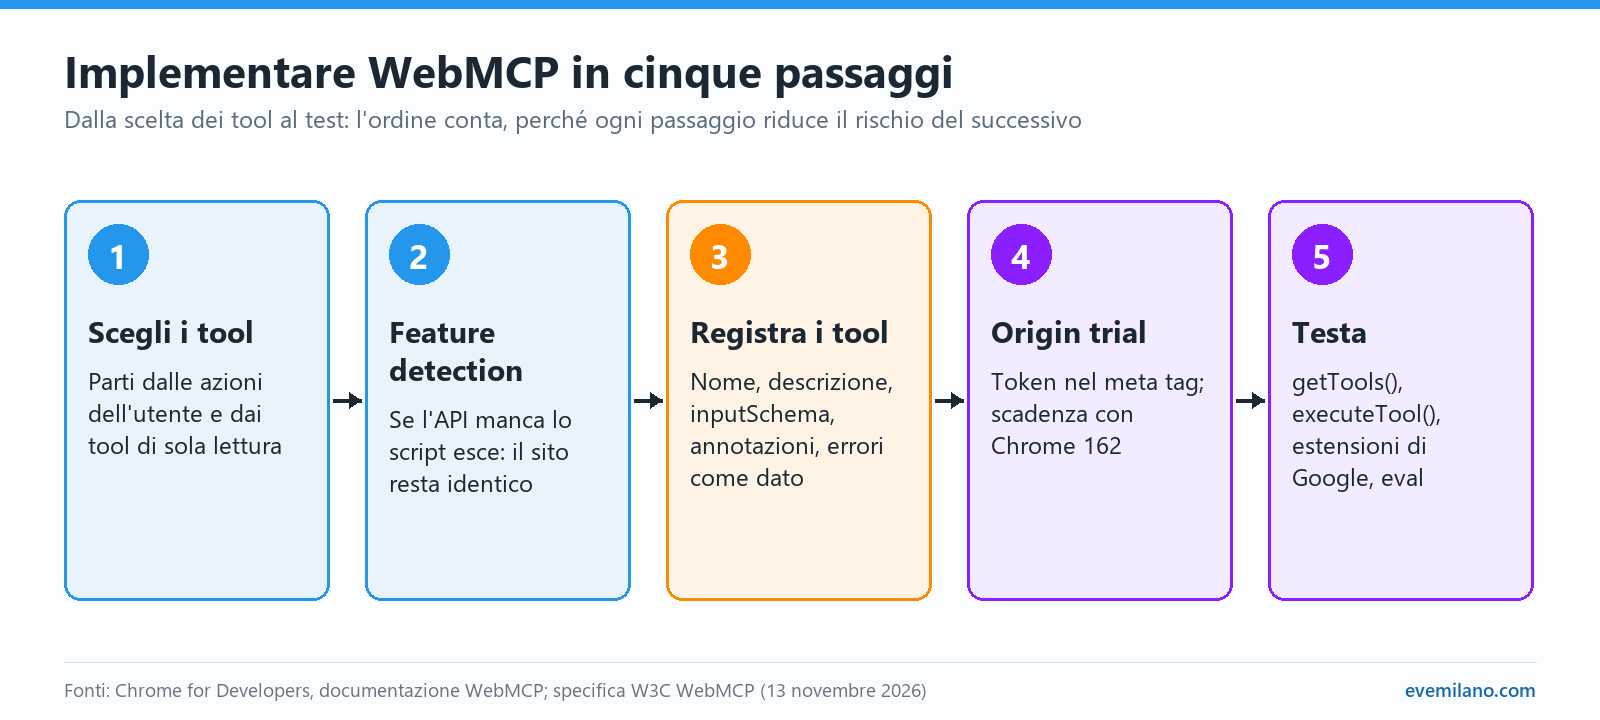
1. Scegliere i tool partendo dalle azioni dell’utente
Google propone un metodo in tre fasi (Build your user’s agentic workflows):
- definire l’obiettivo dell’utente,
- definire lo stato iniziale (dove si trova l’utente, cosa sa già l’agente, quali vincoli ci sono, per esempio il login)
- simulare la conversazione turno per turno, chiedendosi a ogni passaggio quale tool serve e come deve reagire il sito.
Nella pratica conviene partire dai tool di sola lettura: ricerca interna, filtri, indice di un contenuto lungo, stato di un ordine. Sono quelli a rischio più basso, permettono di verificare il comportamento degli agenti senza effetti collaterali e coprono già una parte importante delle richieste. I tool che modificano dati (carrello, prenotazioni, invio di richieste) vengono dopo, quando le regole di conferma e validazione sono chiare.
Due vincoli da tenere presenti fin dall’inizio:
- pochi tool, senza sovrapposizioni: non c’è un numero massimo, ma ogni tool occupa contesto e più tool simili rendono più difficile la scelta per l’agente (WebMCP best practices);
- un tool, una funzione: il nome deve distinguere l’esecuzione dall’avvio di un processo, per esempio
create-event(crea subito) estart-event-creation-process(porta al form).
2. Feature detection e progressive enhancement
WebMCP va aggiunto come miglioramento progressivo: se il browser non supporta l’API, lo script non deve fare nulla e il sito deve restare identico. Il controllo è una riga. Questo è l’esempio di OpenAI, un tool di sola lettura che restituisce il titolo della pagina (ChatGPT Learn, Site tools):
if (typeof document.modelContext?.registerTool === "function") {
  await document.modelContext.registerTool({
    name: "get_page_title",
    description: "Read the title of the current page.",
    inputSchema: {
      type: "object",
      properties: {},
      additionalProperties: false,
    },
    annotations: { readOnlyHint: true },
    execute: async () => ({ title: document.title }),
  });
}
Il costo per chi non usa un agente si riduce così al download dello script. Se lo si carica in defer e in fondo alla pagina, non interferisce con il rendering.
3. Origin trial: registrazione e token
Per attivare l’API in produzione su Chrome devi registrare il dominio qui e si ottiene un token legato all’origine. Il token va inserito nelle pagine, per esempio in un meta tag http-equiv="origin-trial" nell’<head>. Tre accortezze:
- il token vale per l’origine registrata, protocollo e host compresi:
wwwe dominio nudo sono origini diverse; - il trial ha una scadenza (oggi Chrome 162, con la console che indica il 30 marzo 2027): conviene annotarla nel codice, perché dopo quella data il meta tag non serve più e va rimosso;
- il token non è un segreto, viene servito in chiaro a ogni visitatore, ma non va riusato su altri domini.
4. Testare i tool prima di renderli pubblici
Il test ha tre livelli.
- Console. Con il flag attivo,
document.modelContext.getTools()restituisce l’elenco dei tool registrati, in ordine alfabetico, con nome, descrizione, schema, annotazioni e origine.document.modelContext.executeTool(tool, { ... })li esegue con gli argomenti indicati e restituisce il risultato (onullse l’esecuzione provoca una navigazione). È il modo più rapido per verificare che lo schema sia letto come previsto e che l’output abbia la forma giusta. - Agente simulato. Google mette a disposizione due estensioni: Model Context Tool Inspector, per provare i tool con prompt in linguaggio naturale, ed Example Agentic Chrome Extension, che ispeziona, monitora ed esegue i tool e tiene sempre conto delle annotazioni. Entrambe richiedono una chiave API di un modello; la seconda può usare anche un modello locale tramite la Prompt API (Chrome for Developers, WebMCP). Prima di provarle sul proprio sito conviene vederle all’opera sulle demo ufficiali: WebMCP zaMaker e Travel demo per l’API imperativa, Le Petit Bistro per quella dichiarativa.
- Eval. Prima di andare in produzione bisogna verificare che il modello capisca quando chiamare il tool, con quali parametri e con quale risultato atteso. La guida Chrome agli eval propone dataset con chiamate attese (
expectedCall), da costruire con richieste dirette e richieste ambigue, più test deterministici classici per la logica del tool.
5. Tenere l’output sotto controllo
Google raccomanda un massimo di 1.500 caratteri per il risultato di un singolo tool (WebMCP tool security). La soglia si supera facilmente con risultati che sembrano innocui, ad esempio con un elenco di sezioni in cui ogni voce ripete l’URL completo, o una ricerca che restituisce tutti i campi dell’endpoint invece dei tre che servono.
Le regole che sto applicando:
- restituire solo i campi che servono all’agente per il passo successivo;
- non ripetere dati costanti: un URL base una sola volta, poi i soli frammenti o ID;
- limitare il numero di risultati in modo esplicito e dichiararlo nella descrizione;
- usare
outputSchemasui tool di ricerca con più campi, ometterlo sulle letture semplici.
6. Un esempio su WordPress
Su WordPress il punto di ingresso naturale è un plugin, non il tema: i tool sopravvivono a un cambio di tema e restano versionati separatamente. Per verificare il metodo su un caso reale ho scritto un plugin che espone due tool di sola lettura su un blog:
cerca_articoli, che interroga l’endpoint REST di ricerca del tema e restituisce fino a 8 risultati con titolo, URL e tipo;indice_articolo, registrato solo sui singoli articoli, che restituisce titolo, URL e l’elenco degli H2 con la loro ancora.
Le scelte del plugin seguono i passaggi descritti sopra. La parte PHP fa due cose: stampa il meta tag dell’origin trial in wp_head con priorità alta e carica lo script nel footer in defer, passandogli la configurazione. Estratto da eve_webmcp.php:
const EVE_WEBMCP_OT_TOKEN = 'IL_TUO_TOKEN';
const EVE_WEBMCP_VERSION = '1.0.0';

add_action(
    'wp_head',
    function() {
        if ('' !== EVE_WEBMCP_OT_TOKEN) {
            printf('<meta http-equiv="origin-trial" content="%s">'.
                "\n", esc_attr(EVE_WEBMCP_OT_TOKEN));
        }
    },
    1
);

add_action(
    'wp_enqueue_scripts',
    function() {
        if (is_admin()) {
            return;
        }

        wp_enqueue_script(
            'eve-webmcp',
            plugins_url('webmcp.js', __FILE__),
            array(),
            EVE_WEBMCP_VERSION,
            array(
                'in_footer' => true,
                'strategy' => 'defer',
            )
        );

        wp_add_inline_script(
            'eve-webmcp',
            'window.eveWebmcp = '.wp_json_encode(
                array(
                    'searchEndpoint' => rest_url('searchroute/v1/search'),
                    // Il tool indice_articolo si registra solo sui singoli articoli del blog.
                    'isPost' => is_singular('post'),
                )
            ).
            ';',
            'before'
        );
    }
);
La decisione su quali tool registrare viene presa lato server (is_singular( 'post' )) e passata allo script: il JavaScript non deve indovinare il tipo di pagina. L’endpoint searchroute/v1/search è quello del tema in uso; su un altro sito si sostituisce con l’endpoint di ricerca disponibile.
Nel file JavaScript, mc è il riferimento a document.modelContext. Lo script esce alla prima riga se l’API non c’è, e ogni registrazione è isolata in una promise con catch, così un errore su un tool non blocca l’altro. Estratto da webmcp.js, registrazione di cerca_articoli:
if (!mc || typeof mc.registerTool !== 'function') return;

const cfg = window.eveWebmcp || {};
const MAX_RESULTS = 8;

const register = (tool) =>
Promise.resolve()
.then(() => mc.registerTool(tool))
.catch((err) => console.warn('[eve-webmcp] registrazione non riuscita:', tool.name, err));

// Tool 1: ricerca nei contenuti del sito (endpoint del tema, pubblico e di sola lettura).
if (cfg.searchEndpoint) {
  register({
    name: 'cerca_articoli',
    description: 'Cerca negli articoli del blog e nelle pagine di EVE Milano (SEO, Google Ads, GA4, AI, Python). ' +
    'Restituisce fino a 8 risultati con titolo, URL e tipo; le pagine servizio vengono prima degli articoli. ' +
    'Usalo per trovare il contenuto pertinente prima di aprirlo.',
    inputSchema: {
      type: 'object',
      properties: {
        query: {
          type: 'string',
          description: 'Parole chiave in italiano, almeno 3 caratteri. Es.: "analisi log", "crawl budget".',
          minLength: 3,
          maxLength: 100,
        },
      },
      required: ['query'],
      additionalProperties: false,
    },
    outputSchema: {
      type: 'object',
      properties: {
        query: {
          type: 'string'
        },
        results: {
          type: 'array',
          items: {
            type: 'object',
            properties: {
              title: {
                type: 'string'
              },
              url: {
                type: 'string'
              },
              type: {
                type: 'string',
                enum: ['post', 'page']
              },
            },
            required: ['title', 'url', 'type'],
          },
        },
        error: {
          type: 'string'
        },
      },
      required: ['query', 'results'],
    },
    annotations: {
      readOnlyHint: true
    },
    execute: async ({
      query
    }, opts) => {
      const url = new URL(cfg.searchEndpoint, location.origin);
      url.searchParams.set('term', String(query || '').trim());
      const res = await fetch(url, {
        signal: opts && opts.signal,
        credentials: 'same-origin'
      });
      if (!res.ok) {
        // Errore restituito come dato: un'eccezione arriva all'agente solo come errore generico, senza messaggio.
        return {
          query,
          results: [],
          error: `Ricerca non riuscita (HTTP ${res.status}). Servono almeno 3 caratteri.`
        };
      }
      const data = await res.json();
      return {
        query,
        results: (data.results || []).slice(0, MAX_RESULTS).map(({
          title,
          url,
          type
        }) => ({
          title,
          url,
          type
        })),
      };
    },
  });
}
Le scelte da notare, una per una:
- Lunghezze nei limiti. La descrizione di
cerca_articoliè di 258 caratteri, quella del parametroquerydi 82: sotto i 500 e i 150 raccomandati da Google. La descrizione dice cosa restituisce il tool e quando usarlo, senza istruzioni negative. - Vincoli nello schema e nel codice.
minLength: 3emaxLength: 100guidano l’agente, ma la validazione vera resta all’endpoint. Se la ricerca fallisce, il tool restituisce un messaggio che dice come correggere la richiesta (“Servono almeno 3 caratteri”), come raccomanda Google per permettere all’agente di riprovare. - Errore restituito, non lanciato. È la riga che ho corretto dopo il test (vedi sotto): l’errore è un campo del risultato, dichiarato anche in
outputSchema, e non un’eccezione. - Output ridotto. L’endpoint restituisce più campi; il tool ne tiene tre e taglia a 8 risultati. Il
signaldell’annullamento è passato afetch(). outputSchemasolo dove serve. C’è sulla ricerca, che restituisce un elenco con più campi. Suindice_articolo, una lettura dall’output ovvio, è omesso.
Il secondo tool mostra il principio dei dati non ripetuti. Estratto da webmcp.js, funzione execute di indice_articolo:
execute: async () => {
    const base = location.origin + location.pathname;
    // Solo l'ancora, non l'URL intero: resta sotto i ~1.500 caratteri consigliati per l'output.
    const sections = [...document.querySelectorAll('.entry-content h2[id]')].map((h) => ({
        title: h.textContent.trim(),
        anchor: `#${h.id}`,
    }));
    const h1 = document.querySelector('h1');
    return {
        title: (h1 ? h1.textContent : document.title).trim(),
        url: base,
        sections
    };
},
L’URL della pagina compare una volta sola, ogni sezione porta solo la propria ancora. Su una guida con molti H2 la differenza tra le due forme è quella che separa un output sotto la soglia da uno sopra. Il selettore .entry-content h2[id] dipende dal markup del tema e va adattato; funziona solo se gli H2 hanno un id, cosa che su WordPress dipende dal tema o dall’editor.
Cosa ha mostrato il test (e consigli)
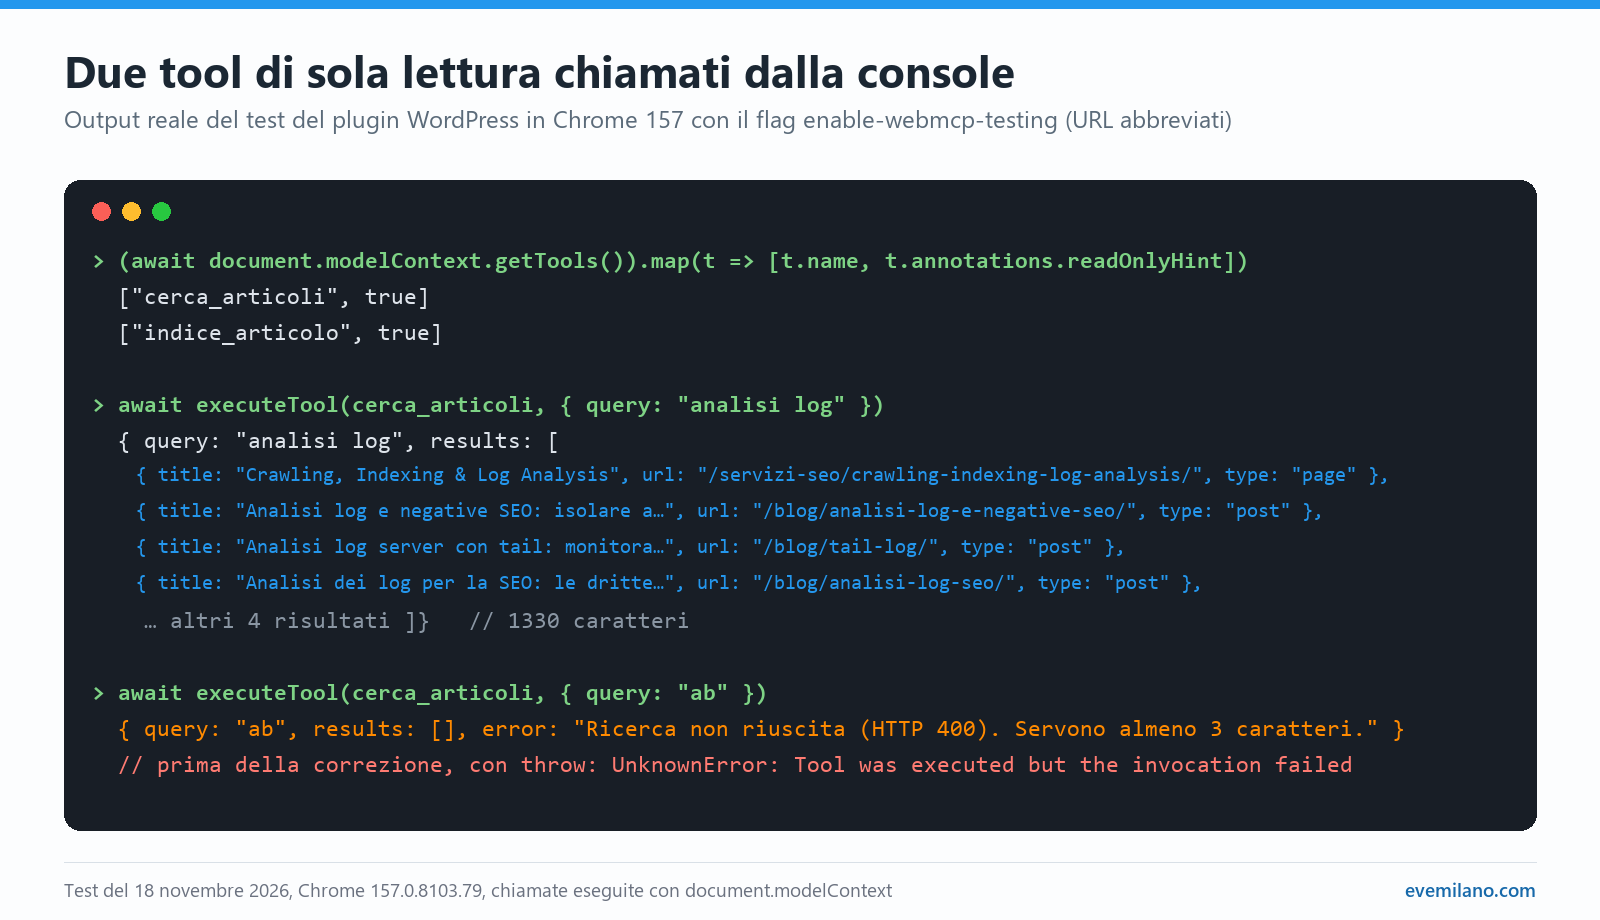
Ho provato il plugin in Chrome 157 con il flag enable-webmcp-testing attivo, chiamando i tool dalla console con getTools() ed executeTool() su un articolo reale. Quattro risultati sono utili a chiunque implementi WebMCP:
- Un’eccezione non arriva all’agente. Nella prima versione il tool lanciava un
Errorquando la ricerca falliva. Con una query di due caratteri,executeTool()restituiva soloUnknownError: Tool was executed but the invocation failed: il messaggio “Servono almeno 3 caratteri” si perdeva. Restituendo l’errore come dato ({ query, results: [], error: "..." }) il messaggio arriva intatto, e l’agente sa come correggere la richiesta. - I vincoli dello schema non vengono applicati dal browser. Con
minLength: 3dichiarato, una query di due caratteri ha comunque eseguito la funzione. È la conferma pratica della regola di Google: lo schema guida il modello, la validazione sta nel codice. outputSchemaprima di Chrome 159 non rompe nulla. Su Chrome 157 la registrazione conoutputSchemava a buon fine, magetTools()non riporta lo schema. Si può quindi dichiararlo già oggi senza rischi per i browser meno recenti.- L’output resta sotto la soglia. La ricerca con 8 risultati produce 1.330 caratteri; l’indice di un articolo con 9 H2, con l’URL una sola volta e le sole ancore, 1.321. Entrambi sotto i 1.500 raccomandati, ma non di molto: con l’URL completo ripetuto per ogni sezione la soglia si supera facilmente.
C’è un punto in cui il mio plugin di test si discosta consapevolmente da una raccomandazione di Google, che suggerisce di registrare tutti i tool insieme e di annullare l’intero gruppo se una registrazione fallisce (WebMCP best practices). La regola ha senso quando i tool compongono un flusso, per esempio ricerca, carrello e checkout: lasciarne attiva solo una parte renderebbe il flusso inutilizzabile.
Nel mio esempio i due tool sono indipendenti e di sola lettura, quindi isolare gli errori è la scelta più robusta.
Sicurezza: cosa può andare storto
Prompt injection indiretto
Un modello linguistico tratta istruzioni, testo e dati dell’utente come un’unica sequenza di token. Questo lo espone al prompt injection indiretto: istruzioni malevole nascoste nei contenuti che il modello legge. La guida Chrome alla sicurezza dei tool è netta: non è possibile garantire la sicurezza dentro un modello, che per natura è probabilistico.
Per chi espone tool, le contromisure sono tre:
untrustedContentHintsu ogni tool che restituisce contenuti generati dagli utenti o dati esterni: commenti, recensioni, testi importati;consequentialHintsu ogni tool che produce azioni rilevanti o irreversibili, così che agente e browser chiedano conferma;- separare l’input grezzo dal contesto applicativo: un’istruzione testuale non affidabile non va mai trattata come un’autorizzazione.
Per le azioni rilevanti Google suggerisce di legare l’approvazione al piano esatto, con un permesso di breve durata che includa contenuto, versione, ambito e scadenza: qualsiasi modifica deve revocarlo.
A chi esporre i tool
Per impostazione predefinita altri siti e iframe di altri domini non vedono i tool. Con exposedTo li si rende visibili a origini specifiche, e qui serve prudenza: anche un tool di sola lettura come getFavoriteProducts può rivelare informazioni sull’utente, quindi va esposto solo a siti con cui si condividerebbero comunque quei dati. I tool che scrivono agiscono per conto dell’utente e vanno esposti solo a origini di cui ci si fida per quel tipo di azione.
Le estensioni Chrome
Le estensioni Chrome possono leggere ed eseguire i tool WebMCP tramite content script. È un dato da tenere presente: un’estensione con i permessi sul dominio può comunque eseguire JavaScript nella pagina anche senza WebMCP, ma un tool ben documentato rende più facile chiamare la funzione esposta. Ogni tool va quindi progettato come una API pubblica, con validazione e autorizzazioni lato applicazione.
Limiti di lunghezza consigliati
Google raccomanda questi limiti per ridurre il rischio di incappare nelle protezioni degli agenti e ottenere risultati migliori. Sono raccomandazioni, possono cambiare e potrebbero entrare in futuro nella specifica.
| Elemento | Limite consigliato |
|---|---|
| Descrizione del tool | 500 caratteri |
| Descrizione di un parametro | 150 caratteri |
| Nome di tool e parametri | 30 caratteri |
| Risultato di un tool | 1.500 caratteri |
Come scrivere tool che gli agenti usano bene
La qualità di un tool si misura su una cosa sola: l’agente lo sceglie quando serve, con i parametri giusti, e sa cosa fare con il risultato. Le indicazioni di Google (best practices, build tools, evals) si riducono a poche regole operative.
- Descrizioni in positivo. Descrivere cosa fa il tool e quando usarlo, non cosa non fa. “Crea un evento in calendario in una data e ora specifiche” funziona meglio di “Non usare questo tool per il meteo”.
- Accettare l’input dell’utente così com’è. Se l’utente scrive “dalle 11 alle 15”, il tool accetta la stringa; non deve chiedere all’agente di calcolare i minuti.
- Valori parlanti.
shipping="Express"invece dishipping_id=1: il modello sceglie meglio quando capisce il significato. - Validare con rigore nel codice, con elasticità nello schema. I vincoli dello schema aiutano ma non sono garantiti; la validazione vera sta nella funzione.
- Errori che guidano, restituiti come dato. Un errore deve dire all’agente come rimediare: “Nessun risultato di ricerca. Cerca prima i voli” vale più di un codice HTTP grezzo. E va restituito nel risultato, non lanciato come eccezione, altrimenti il messaggio può perdersi per strada (è quanto ho osservato in Chrome 157).
- Confermare solo a stato aggiornato. Il tool restituisce successo quando lo stato dell’applicazione corrisponde all’output, non prima.
- Testare con eval. Verificare in isolamento la scelta del tool e i parametri, poi i percorsi completi, compresi i fallimenti a metà catena.
- Registrare le versioni nei test. Revisione della specifica, versione del browser, client e modello: in una tecnologia in trial i comportamenti cambiano da una versione all’altra.
Cosa cambia per la SEO (e cosa no)
Non è un fattore di ranking
Nessuna delle fonti ufficiali presenta WebMCP come segnale per la ricerca, e non va presentato così. Non è un dato strutturato che un motore indicizza, non è una direttiva per i crawler, non entra nel modo in cui Google valuta una pagina.
I tool non si scoprono con un crawl
Google lo indica tra i limiti di WebMCP: client e browser devono visitare il sito per sapere se ha tool richiamabili. I tool esistono solo quando la pagina è aperta e lo script è stato eseguito. Ne derivano tre conseguenze pratiche:
- visitatori normali: se il browser non supporta l’API, lo script esce e la pagina resta identica;
- Googlebot e crawler AI come GPTBot o ClaudeBot: non eseguono un agente nel browser, quindi per loro i tool non esistono. Sono due mondi diversi, come spiegato nella guida ai crawler AI;
- assistenti che citano il sito lato server: quando ChatGPT, Claude o Perplexity leggono una pagina per rispondere a una domanda, non usano WebMCP. La visibilità nelle risposte AI dipende da altri fattori.
Dove ha senso
WebMCP ha valore dove l’utente compie azioni: ricerca interna, filtri su cataloghi ampi, prenotazioni, carrello, moduli complessi, assistenza clienti. Su un sito editoriale l’utilità è minore ma reale: ricerca nei contenuti e navigazione nelle guide lunghe sono i casi tipici.
Il tema si inserisce in un discorso più ampio, l’accessibilità del sito per gli agenti AI: contenuto leggibile senza JavaScript per chi legge lato server, markup semantico e form accessibili per chi agisce nel browser, tool espliciti per gli agenti che li supportano. È il perimetro dell’analisi di accessibilità per motori di ricerca e AI.
Rapporto con dati strutturati e robots
Sono piani diversi e nessuno sostituisce l’altro. I dati strutturati descrivono il contenuto della pagina a chi la legge; robots.txt e meta robots regolano l’accesso dei crawler; WebMCP dichiara le azioni disponibili a un agente che opera nel browser con l’utente presente. Un sito ben fatto per gli agenti ha bisogno di tutti e tre.
Domande frequenti
WebMCP è uno standard approvato?
No. È una proposta sviluppata nel W3C Web Machine Learning Community Group, con lo stato di Draft Community Group Report. La versione corrente è del 13 novembre 2026 e l’API può ancora cambiare.
Quali browser supportano WebMCP?
Chrome, in origin trial da Chrome 149 fino a Chrome 162, e in sviluppo locale tramite il flag chrome://flags/#enable-webmcp-testing. ChatGPT usa i Site tools, la sua implementazione di WebMCP, solo nel browser integrato dell’app desktop. Per Firefox, Safari ed Edge non ci sono annunci ufficiali.
WebMCP sostituisce un server MCP?
No. MCP collega un agente a un server ed è sempre disponibile; WebMCP collega l’agente alla pagina aperta e usa la sessione dell’utente. Un sito può usare entrambi: MCP per dati e logica di base, WebMCP per le azioni durante la navigazione.
Meglio l’API imperativa o quella dichiarativa?
La dichiarativa è la scelta più rapida quando l’azione è già un form pulito, senza campi tecnici nascosti né consensi. L’imperativa serve quando si vuole controllare esattamente parametri, output e annotazioni, o quando l’azione non corrisponde a un form.
WebMCP migliora il posizionamento su Google?
No. Nessuna fonte ufficiale lo indica come fattore di ranking. I tool non vengono scoperti dai crawler e non vengono indicizzati.
Aggiungere WebMCP rallenta il sito?
Se lo script è caricato in defer e termina subito quando l’API non è disponibile, il costo per i visitatori senza agente si limita al download del file. I tool vengono eseguiti solo quando un agente li chiama.
Il token dell’origin trial va tenuto segreto?
No, viene servito in chiaro nell’HTML di ogni pagina. È legato all’origine registrata e ha una scadenza: alla fine del trial va rimosso.
Fonti
- Specifica WebMCP, W3C Web Machine Learning Community Group, Draft Community Group Report del 13/11/2026
- Chrome for Developers, WebMCP (aggiornata il 07/10/2026)
- Chrome for Developers, Imperative API (16/11/2026)
- Chrome for Developers, Declarative API (25/09/2026)
- Chrome for Developers, When to use WebMCP and MCP (27/10/2026)
- Chrome for Developers, WebMCP tool security (01/09/2026)
- Chrome for Developers, Build your user’s agentic workflows with WebMCP tools (30/10/2026)
- Chrome for Developers, WebMCP best practices (30/10/2026)
- Chrome for Developers, Test WebMCP with Evals (28/05/2026)
- ChromeStatus, WebMCP
- ChatGPT Learn, Site tools
- Plugin WordPress
eve_webmcp(codice dell’autore), fileeve_webmcp.phpewebmcp.js
Articoli correlati
Autore
Mi chiamo Giovanni Sacheli e dal 2009 aiuto le aziende a farsi trovare online. Sono specializzato in SEO tecnica e PPC, competenze che applico quotidianamente nella mia agenzia, Searcus Swiss Sagl. Mi piace sviluppare strumenti a supporto del mio lavoro, ho creato SEOdata.app e cluster.army e co-scritto il libro SEO Audit Avanzato. Curo maniacalmente questo blog per colleghi e appassionati, dove mi "appunto" quello che imparo. Sono un NERD anni '80, motociclista e orgoglioso papà di due bambini.
Link:
Giovanni Sacheli
SEO Audit Avanzato
Searcus Swiss Sagl
SEOdata.app
cluster.army